Что такое Load Average. Определяем среднюю нагрузку на сервер
Верная оценка нагрузки системы складывает характеристику производительности и работоспособности системы в целом. Что есть важной деталью при мониторинге сервера.
Load Average (LA, средняя нагрузка) — это средняя мера нагрузки, отображается в количестве процессов, которые находятся в состоянии выполнения или в состоянии ожидания ресурсов за интервал времени 1, 5 и 15 минут. Так как нагрузка колеблется быстро из-за кратковременных процессов, более полезно смотреть на среднюю нагрузку с течением времени, что дает лучший обзор. Эти цифры могут рассказать много о том, насколько заняты процессор, диск и другие элементы системы.
Самый простой способ увидеть среднее значение нагрузки на сервере с ОС Linux — это запустить команду uptime в терминале. Команда uptime на выводе отображает текущее время, продолжительность работы системы, количество пользователей, вошедших в систему, и средние значения нагрузки системы за последние 1, 5 и 15 минут.

Note: за пример взята нагрузка на сервере нашего минимального тарифа VPS с 1 ядром.
Получив 3 значения за разные промежутки времени можно понять состояние системы и проанализировать динамику нагрузки, если все полученные значения равны 0 — значит система в режиме ожидания, если значения увеличиваются (для 1, 5 и 15 минут соответственно) — нагрузка в системе растет, уменьшаются — нагрузка падает.
Эти значения мало что говорят без количества выполняемых и общих процессов в системе. Посмотреть общее количество активных и ожидающих процессов можно командой top. Также эта команда выведет среднее значение по нагрузке (как и команда uptime), самые тяжелые процессы в порядке спадания и другую важную информацию.
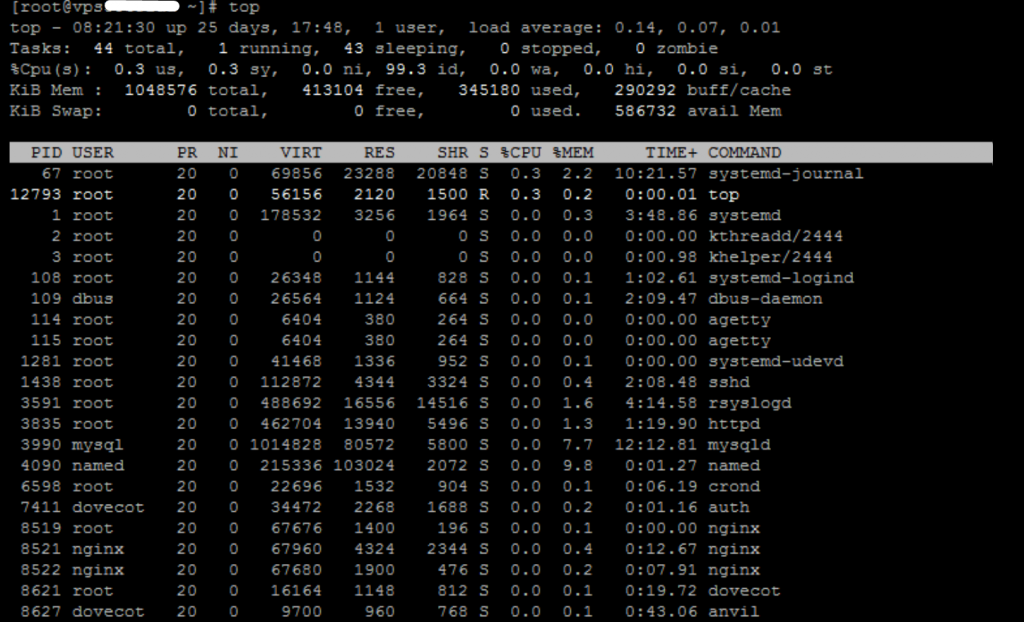
Или же как вариант, использовать команду. Где после выполнения команды, возвращаются значения, где первые три поля содержат среднюю нагрузку, в 4 поле перед слешем идет количество запущенных процессов, после слеша сумма всех процессов в системе в текущее время, и в конце выведен индикатор процесса. Как можно уже видеть, существует много способов проверить среднюю нагрузку в системе.

Для просмотра всех процессов в системе вводим в терминал команду ps auxfS.
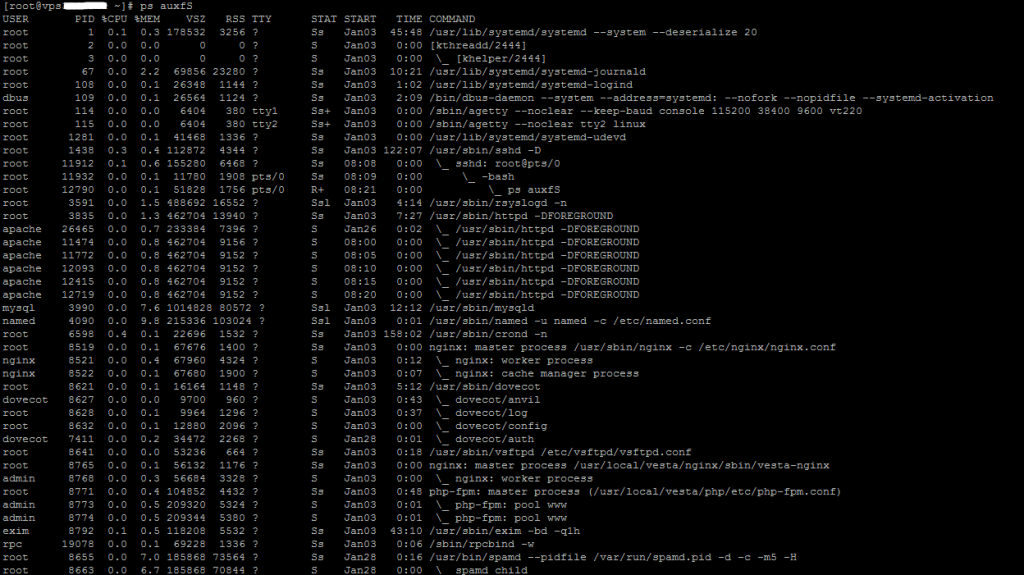
Если желаете закрыть ненужный процесс (например, cron) для освобождения ресурсов вбиваем в консоль команду kill после чего ставим PID процесса (индикатор процесса). PID процесса см. сверху на скрине во втором столбике. Это действие нужно выполнять с большой осторожностью и понимать, какой процесс за что отвечает.

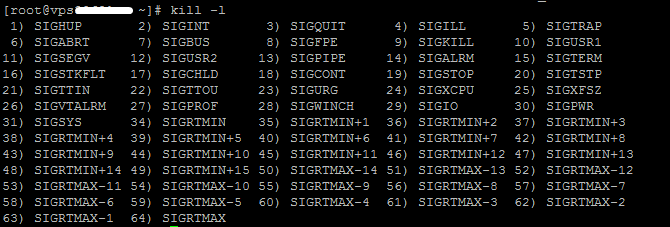
Если процесс не остановлен попробуйте использовать сигнал SIGKILL, под номером 9, он должен полностью уничтожить процесс.

Номера всех сигналов можно узнать с помощью команды kill -l.
Чтобы правильно интерпретировать среднее значение нагрузки нужно знать сколько ядер имеет процессор. Так как правило, для 1 ядерного процессора при его использовании на 100% это будет отображаться по средней нагрузки как 1.00, на двухъядерном процессоре полная занятость процессора будет выдаваться по нагрузке как 2.00, для 3-х ядер как 3.00 и так далее. То-есть если мы имеем нагрузку 0,01 для 1 ядра следует, что 99% процессорного времени процессор находится в простое. Если для 1 ядерного процессора среднее значение нагрузки больше 1, например равно 1,5, этот факт определяет, что количество текущих процессов превышает допустимое количество запущенных процессов, которые процессор может обрабатывать одновременно, и процессы ожидали 50% процессорного времени в очереди до своего выполнения. Чем значение по нагрузке ниже тем конечно лучше.
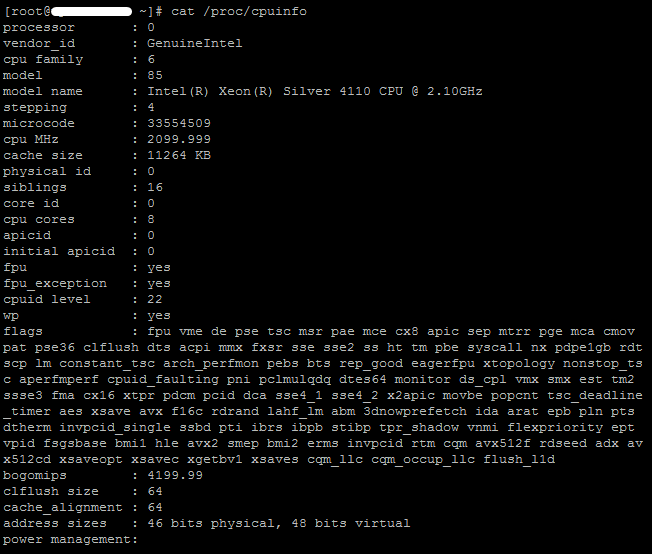
Узнать количество ядер на сервер можно командой grep ‘model name’ /proc/cpuinfo | wc -l, на выводе получите количество ядер на вашем сервере. Как видим, на тарифе VPS Мини мы имеет сервер с 1 ядром.

Полную информацию касательно процессора можно узнать используя команду cat /proc/cpuinfo.
В системе может быть много скачков в течение более длительного периода времени, например, при запуске некоторых неисправных процессов, при выполнении заданий cron, когда за короткий промежуток времени подключается больше пользователей или когда сервер подвергается атакам, поэтому лучше не опираться только на uptime или top команды, а дополнительно полагаться на инструменты мониторинга, таких как Zabbix, Nagios, Monit, которые регистрируют на активность процессора и памяти в долгосрочной перспективе. Больше информации касательно систем мониторинга серверов можно узнать в нашей статье здесь.
Специалисты ГиперХост всегда рады предоставить помощь и консультирование всем нашим клиентам касательно вопросов по нагрузке на сервере.
что такое load average

Очередь образуется по причине ожидания таких ресурсов, как центральный процессор, дисковая подсистема ввода/вывода или сетевая подсистема ввода/вывода.
Дополнительный вопрос: — какой load average можно считать нормальным или допустимым?
Ответ:
Если речь о CPU load average, то это зависит о количества ядер CPU на вашем сервере.
В один момент времени одно ядро может выполнять только один процесс.
Планировщик ядра распределяет вычислительные возможности процессора между всеми процессами выполняемыми в системе и создаётся иллюзия одновременной работы.
Всегда какое то количество процессов стоит в очереди.
Если речь идет о системе с одним ядром CPU, то при:
load average < 1 - идеальная ситуация, сервер не нагружен load average 1 - 3 сервер нагружен но работает в норм режиме
load average 3 — 10 сервер загружен довольно сильно, надо следить за нагрузкой и выявлять причины такой нагрузки
load average > 10 сервер перегружен, надо принимать меры
load average > 20 сервер сильно тормозит, трудно получить ответ сервера
Если у Вашего сервера несколько ядер, то эти цифры надо увеличить на количество ядер.
Записки IT специалиста
Linux — начинающим. Что такое Load Average и какую информацию он несет
- Автор: Уваров А.С.
- 29.06.2016
С необходимостью правильно оценить нагрузку на систему сталкивается каждый системный администратор. Если говорить о Linux-системах, то одним из основных терминов, с которым придется столкнуться начинающему администратору окажется Load Average (средняя загрузка). Однако, если говорить о русскоязычном сегменте сети интернет, описание данного параметра сводится к общим малозначащим фразам, в то время как за этими простыми цифрами кроется глубокий пласт информации о работе системы.
Научиться настраивать MikroTik с нуля или систематизировать уже имеющиеся знания можно на углубленном курсе по администрированию MikroTik. Автор курса, сертифицированный тренер MikroTik Дмитрий Скоромнов, лично проверяет лабораторные работы и контролирует прогресс каждого своего студента. В три раза больше информации, чем в вендорской программе MTCNA, более 20 часов практики и доступ навсегда.
Если обратиться к популярным источникам (Википедия), то можно найти примерно следующее:
Средняя загрузка — среднее значение загрузки системы за некоторый период времени, как правило, отображается в виде трёх значений, которые представляют собой усредненные величины за последние 1, 5 и 15 минут, чем ниже, тем лучше. В UNIX это среднее значение вычислительной работы, которую выполняет система.
После прочтения данного абзаца никаких новых знаний, кроме того, что масло таки масляное (средняя загрузка — среднее значение загрузки) не возникает и понимания ситуации не прибавляется. Чем ниже, тем лучше, но насколько ниже и относительно чего.
Посмотреть текущую загрузку системы можно командной
uptimeТакже ее значения выводят утилиты top и htop, а также множество других инструментов. В ответ мы получим что-то вроде:
load average: 0,12, 0,10, 0,03Много это или мало? Хорошо или плохо? Давайте разбираться.
Чтобы понять, что такое загрузка системы следует обратиться к логике работы центрального процессора. Вне зависимости от того, мощный у вас процессор или слабый, многоядерный или нет, он выполняет некий программный код для некоторых процессов. Если процесс один, то вопросов нет, а вот когда их несколько? Надо как-то распределять ресурсы между ними и, желательно, равномерно, чтобы один процесс, «дорвавшись» до CPU, не оставил без вычислений другие.
Здесь можно провести аналогию, когда несколько игроков хотят поиграть на одной приставке. Что обычно делают в таких случаях? Договариваются о времени, скажем каждый играет по 15 минут, затем дает поиграть другому.
Процессор поступает аналогичным образом. Каждому нуждающемуся в вычислениях процессу выделяется некий промежуток времени, который зависит от типа процессора и системы, если говорить о современных процессорах Intel, то это значение обычно составляет 10 мс и называется тиком. Каждый тик процессорное время отдается какому-то одному процессу в порядке очереди, но если процесс имеет повышенный или пониженный приоритет, то он, соответственно получит большее или меньшее количество тиков.
Количество использованных тиков, в первом приближении, и представляет загрузку системы. В Linux для оценки загрузки используется интервал в 500 тиков (5 секунд), при этом учитываются как работающие процессы (использованные тики), так и ожидающие (которым не хватило тика, либо они не смогли его использовать, ожидая завершения иной операции).
Если мы используем все тики за указанный промежуток времени и у нас не будет ожидающих сводного тика процессов, то мы получим загрузку процессора на 100% или load average (LA) равное 1.
Давайте рассмотрим следующую схему:
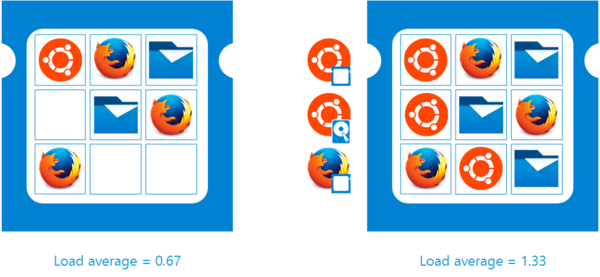
Для простоты мы будем использовать в расчетах более короткий интервал — 9 тиков. На схеме слева мы видим, что процессорные ресурсы сначала понадобились системе, затем браузеру и файловому менеджеру, потом активности в системе не было, затем еще один тик взял файловый менеджер и еще два браузер, последние два тика также не понадобились никому. Несложные расчеты показывают, что мы использовали 67% процессорного времени или load average системы составил 0,67.
Справа показана ситуация, когда каждый тик был занят своим процессом, но некоторые процессы так и не получили своего тика или не смогли получить, например, ждали окончания операции ввода-вывода. В таком случае загрузка процессора составит все те же 100%, но load average вырастет до 1,33, указывая на наличие очереди.
Чтобы лучше понять ситуацию давайте представим себе небольшой супермаркет, касса представляет собой аналог процессора, тик — среднее время обслуживания покупателя (скажем, 1 минута), а процессы — это покупатели. В разгар рабочего дня людей в магазине немного, и вы спокойно прошли на свободную кассу, рассчитались и пошли по своим делам. Это хорошо, но как оценить нагрузку на кассу? Для этого нужно взять некий промежуток времени, допустим 10 минут. Если за 10 минут в магазине кроме вас было еще три человека, то средняя загрузка составит 0,4.
А теперь зайдем в магазин вечером, все кассы заняты, и чтобы оплатить покупки придется ждать. Теперь если за 10 минут касса обслужила 10 человек и еще 10 стоят в очереди, то средняя загрузка будет равна 2, хотя касса загружена всего на 100%.
Вернемся к процессору и еще одному моменту, процессам, ожидающим окончания операций ввода-вывода (диск, сеть и т.п.). Во многих источниках указывается, что такие процессы искажают результат load average и мы можем получить высокие значения LA при отсутствии загрузки процессора. Да, это так. Посмотрим на еще одну схему ниже:
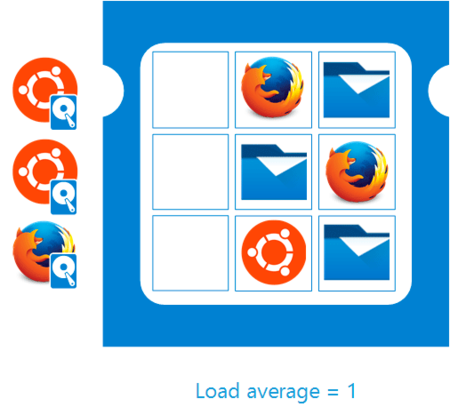
Как видим, из 9 тиков было использовано только 6, т.е. процессор загружен всего на 67%, но так как три процесса ждут данные от диска, то load average по-прежнему равен 1.
Если продолжать аналогию с супермаркетом, то похожая ситуация возникает, когда вы уже подошли к кассе и уже собрались выгружать продукты на ленту, но ваша супруга говорит вам, что она забыла купить хлеб, и вы тут стойте, а она сбегает. Собственно, все что вам остается до того, как она принесет хлеб, это стоять рядом с кассой и ждать, пропуская тех, кто находится в очереди позади вас.
Искажают ли такие процессы значение load average? На наш взгляд нет. Следует понимать, что средняя загрузка — это не показатель производительности процессора, не результат бенчмарка, не текущая нагрузка, а отношение числа процессов, которым требуются вычислительные ресурсы системы к имеющимся в наличии ресурсам.
Т.е. если у нас имеется 1 процессор и 500 тиков, но за это время процессорные ресурсы требуются тысяче процессов, то нагрузка у нас явно вдвое превышает имеющиеся ресурсы. И то, что часть процессов ждут жесткий диск и процессор работает вхолостую, не говорит о том, что система находится в простое, наоборот, она не может обработать нагрузку, правда по другой, не зависящей от процессора причине.
Пользователю ведь все равно по какой причине тормозит сайт или приложение, тем более что недостаток дисковых ресурсов обычно выражается подвисании приложения, в то время как при недостатке процессорных оно просто начинает тормозить.
Подведем промежуточный итог. Load average показывает отношение имеющихся запросов на вычислительные ресурсы к количеству этих самых ресурсов (тиков). Для одного процессора (одного процессорного ядра) использование всех имеющихся ресурсов обозначает load average = 1. Причем это будет справедливо и для Core i7 и для Pentium I, хотя производительность у этих двух процессоров разная.
Теперь перейдем к многопроцессорности и многоядерности. При появлении второго процессора или второго ядра у нас появляются дополнительные вычислительные ресурсы, т.е. же самые 500 тиков. Но за эти 500 тиков система уже может обработать уже 1000 запросов, что покажет нам load average = 2.
Значит ли это, что производительность выросла в два раза? Нет! Производительность зависит от того, сколько вычислений способен произвести процессор в течении одного тика. Понятно, что более мощный процессор выполнит за этот промежуток времени больше вычислений, но оба из них сделают одинаковое число тиков (для каждого процессорного ядра). В многопроцессорных (многоядерных) системах часть процессорного времени вместо вычислений занимают задачи межпроцессорного взаимодействия, переключения контекста и т.д. Поэтому появление второго ядра никогда не даст 100% прироста производительности, но всегда позволяет обработать вдвое большее количество запросов.
Это хорошо видно на примере технологии Hyper-threading, которая позволяет сделать из одного физического ядра процессора два виртуальных. Физическая производительность ядра процессора, т.е. количество производимых им вычислений в единицу времени не меняется, но появляется, хоть и виртуальное, но второе ядро, а это еще 500 тиков. Как показывают тесты, прирост производительности от Hyper-threading составляет 15-30%, что еще раз подтверждает старую поговорку, что лучше плохо ехать, чем хорошо стоять. Второе ядро, хоть и виртуальное, позволяет обрабатывать вычислительные запросы тех процессов, которые в одноядерном варианте стояли бы в очереди.
Непонимание этого момента приводит к тому, что load average ошибочно связывают не с доступностью и достаточностью вычислительных ресурсов, а с производительностью процессора, что приводит к неверным выводам.
Например, переводчик довольно неплохой статьи на Хабре делает ошибочный вывод в отношении Hyper-threading:
Хабраюзер esvaf в комментариях интересуется, как интерпретировать значения load average в случае использования процессора с технологией HyperThreading. Однозначного ответа на данный момент я не нашел. В данной статье утверждается, что процессор, который имеет два виртуальных ядра при одном физическом, будет на 10-30% более производительным, чем простой одноядерный. Если принимать такое допущение за истину, считаю, при интерпретации load average стоит брать в расчет только количество физических ядер.
А Википедия вообще написала полную ерунду (что для технических статей там совсем не редкость):
Средняя нагрузка — это не очень точная характеристика (хотя бы потому, что она определяет усреднённые значения). И если на компьютере есть несколько процессоров, то такой характеристике верить нельзя. Располагая двумя процессорами, можно (теоретически) одновременно выполнять в два раза большее число программ. Это означает, что средняя нагрузка 2.00 (на двухпроцессорном компьютере) будет эквивалентна средней нагрузке 1.00 (на однопроцессорном компьютере). На самом деле это не совсем так. Из-за дополнительной нагрузки, вызванной планированием и некоторыми другими факторами, двухпроцессорный компьютер не обеспечивает удвоения быстродействия по сравнению с однопроцессорным вариантом.
Убедиться, что это не так довольно легко. Если запустить бесконечный цикл командой
perl -e 'while(1)<>'
то мы обеспечим полную загрузку одного процессорного ядра и load average = 1 (в данный момент смотрим только на первые, минутные показания данного параметра).
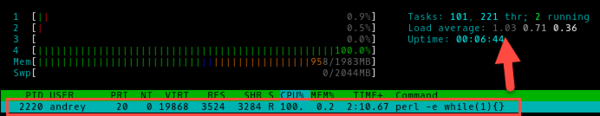
Два процесса:
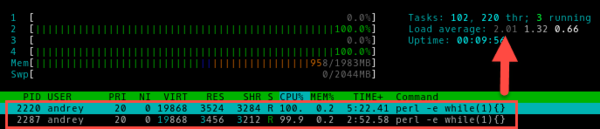
Четыре:
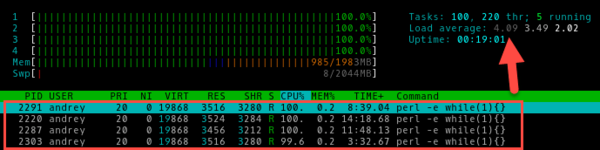
Мы не знаем, сколько именно операций в единицу времени выполняет наш процессор, но нам и не нужно знать это, гораздо важнее понимать, что на текущий момент все вычислительные ресурсы системы задействованы, но недостатка в них нет.
Запустим пятый процесс:
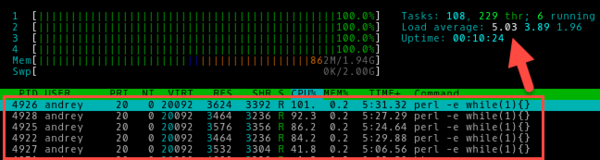
Что изменилось? Загрузка процессора осталась на уровне 100%, это и понятно, выше головы не прыгнешь, но load average вырос до 5, что означает нехватку вычислительных ресурсов примерно на 20%. Таким образом понимание сути значения средней загрузки позволяет администратору однозначно сделать выводы о текущей ситуации, чего не скажешь, глядя просто на индикатор загрузки CPU.
Теперь касательно HyperThreading, виртуализации и т.п. случаев, когда процессор, с которым работает система далеко не соответствует физическому процессору, искусственно создадим данную ситуацию. Для этого запустим на хосте параллельно с виртуальной машиной какой-нибудь ресурсоемкий процесс, например, кодирование видео. Виртуальная машина будет рассчитывать на 4 полных процессорных ядра, а по факту получит в лучшем случае половину их производительности. Проверим?
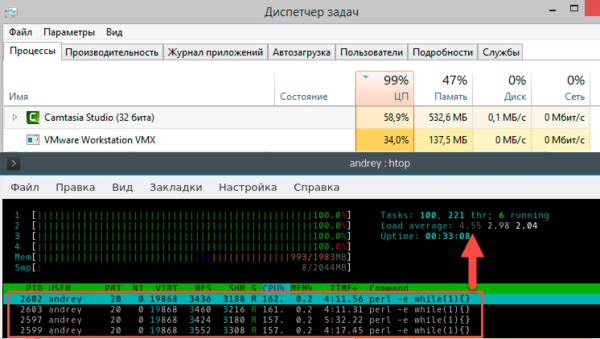
На что следует обратить внимание? В текущих условиях виртуальная машина получает примерно 30-40% загрузки физического процессора. Внутри виртуалки мы видим ожидаемые 100% загрузки процессора, однако если обратить внимание на колонку CPU%, то мы увидим там весьма интересные значения 157-162% загрузки процессора. Почему так происходит? Внутри виртуальной системы тиков CPU хватает всем, но реально гипервизор не выделяет виртуалке процессорного времени. Но это все лирика, что нам показывает load average? Налицо недостаток вычислительных ресурсов — 4,55. Соответствует это реальному положению дел? Да. Нужно ли вносить какие-то коррективы? На наш взгляд — нет.
Теперь уберем стороннюю нагрузку. Гипервизор тут же передаст максимум ресурсов виртуальной машине.
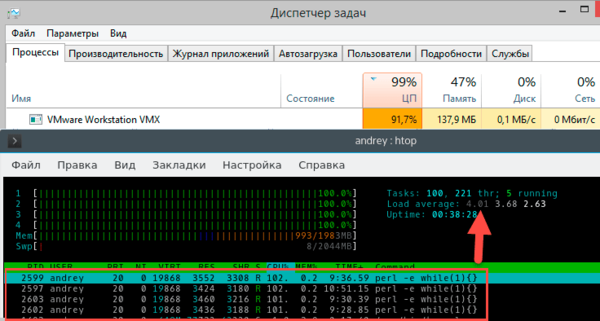
Как видим, вычислительных ресурсов снова стало достаточно и load average опустился до значения 4.
Какие выводы мы можем сделать из этого примера? Что значение load average корректно отражает загрузку системы даже в тех условиях, когда иные показатели не дают корректного представления о происходящих процессах. Так нагрузка на CPU в 157% явно противоречит здравому смыслу, а вот LA = 4,55 вполне реально отражает ситуацию. Поэтому никаких корректив на виртуальные ядра, виртуализацию и т.п. вносить не надо. Load average является относительной величиной и от реальной производительности CPU не зависит в тоже время показывая наличие или дефицит вычислительных ресурсов.
Теперь разберемся с самими цифрами. Мы получаем три значения load average для промежутков в 1, 5 и 15 минут. Как гласит та же Википедия — это средние значения за указанный промежуток времени, что снова неправильно. Для отображения load average используется экспоненциально взвешенная скользящая средняя, подобный тип кривых используется для для сглаживания краткосрочных колебаний и выделения основных тенденций или циклов.
Например, скользящие средние широко применяются в финансовом анализе, для выделения общих тенденций движения курсов валют и акций, позволяя отбросить так называемый «биржевой шум» и понять общие тренды рынка.
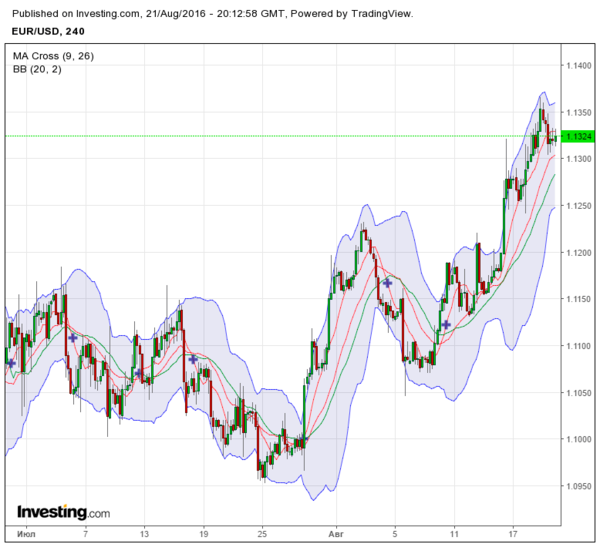
То, что подходит финансисту, наверняка подойдет и системному администратору. В чем основное преимущество скользящих средних? В том, что они позволяют выделить основные тенденции, отбросив кратковременные колебания. Это достоинство, а не недостаток, как пытается убедить нас Википедия:
Средняя нагрузка — это не очень точная характеристика (хотя бы потому, что она определяет усреднённые значения).
Именно усредненные по особому алгоритму значения позволяют нам окинуть ситуацию взглядом вширь и вглубь и разглядеть за деревьями лес. В этом отношении временные значения load average представляют собой не время, за которое посчитали среднее значение, а период времени относительно которого проводится усреднение.
Благодаря автору Хабра ZloyHobbit, который не поленился изучить исходный код Linux, можно точно смоделировать различные значения load average при заданной модели нагрузки. Мы смоделировали ситуацию, когда первые 30 минут единственное ядро CPU было нагружено на 100%, без ждущих в очереди процессов, в последующие полчаса нагрузка была полностью снята.
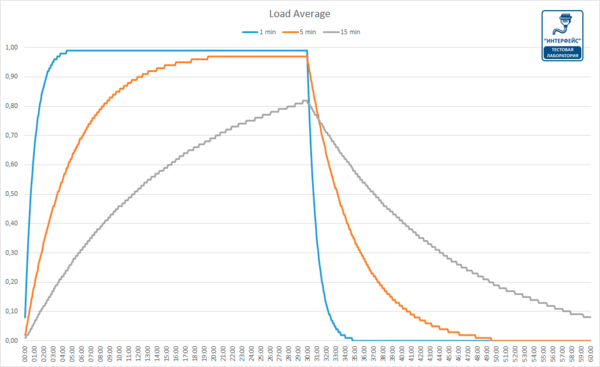
Как видим, разные периоды усреднения дают совершенно различные результаты, так LA 1 (1 min), начинает показывать реальные значения где-то через 4 минуты, LA 5 для отражения текущей нагрузки потребовалось уже 20 минут, а LA 15 за полчаса полной загрузки вышла только на 0,8.
О чем это говорит и как интерпретировать данные значения? Можно сказать, что LA 1 представляет собой недавнее прошлое (несколько минут назад), LA 5 прошлое (полчаса-час) и LA 15 отдаленное прошлое (несколько часов).
Теперь, располагая этим багажом знаний, мы можем правильно интерпретировать простые, на первый взгляд, три числа load average.
Для примера возьмем такое значение:
load average: 0.99 0.75 0.35Это говорит о том, что имеет место достаточно кратковременный (около десятка минут) всплеск нагрузки, при этом вычислительных ресурсов пока достаточно.
load average: 0.00 0.36 0.59Говорит о том, что не так давно система испытывала значительные нагрузки в течении довольно продолжительного времени (полчаса-час).
А вот такая картина:
load average: 4.55 4.22 4.18
Для четырехядерного процессора означает, что он работает на пределе своих возможностей в течении длительного времени (несколько часов).
Как видим, load average, несмотря всего на три цифры, способна представить системному администратору огромный пласт информации о фактической загрузке системы на протяжении последних нескольких часов.
Теперь самое время дать ответы на вопросы, поставленные нами в начале статьи: «Много это или мало? Хорошо или плохо? » Для одного ядра мы считаем приемлемыми следующие значения:
- LA 1 — может превышать 1.00, свидетельствуя о кратковременной пиковой нагрузке на систему.
- LA 5 — не должен превышать 1.00, в противном случае налицо явный недостаток вычислительных ресурсов.
- LA 15 — максимальное значение 0.7 — 0.8, но в любом случае не выше 1.0, в противном случае вы можете получить в три часа ночи звонок от руководства с вопросом: » А что это с нашим сервером. «
На многоядерной (многопроцессорной) системе значения load average следует откорректировать пропорционально числу ядер. Узнать их количество можно командой
nproccat /proc/cpuinfo | grep "cpu cores"Так, например, с учетом вышесказанного, для четырехядерной системы LA 15 не должен превышать 3.00, для двухядерной 1.5, а для одноядерной 0.75.
Теперь, понимая, что такое load average и каким образом формируются его значения вы всегда сможете быстро оценить производительность собственной системы и вовремя принять меры если в работе вашего сервера возникнут узкие места.
Научиться настраивать MikroTik с нуля или систематизировать уже имеющиеся знания можно на углубленном курсе по администрированию MikroTik. Автор курса, сертифицированный тренер MikroTik Дмитрий Скоромнов, лично проверяет лабораторные работы и контролирует прогресс каждого своего студента. В три раза больше информации, чем в вендорской программе MTCNA, более 20 часов практики и доступ навсегда.
Дополнительные материалы:
- Linux — начинающим. Часть 1. Первое знакомство
- Linux — начинающим. Часть 2. Установка Ubuntu Server
- Linux — начинающим. Часть 3. Установка Debian 7 для сервера
- Linux — начинающим. Часть 4. Работаем с файловой системой. Теория
- Linux — начинающим. Часть 4. Работаем с файловой системой. Практика
- Linux — начинающим. Часть 5. Управление пакетами в Debian и Ubuntu
- Linux — начинающим. Часть 6. Управление пользователями и группами. Теория
- Linux — начинающим. Часть 6. Управление пользователями и группами. Практика
- Linux — начинающим. Часть 7. Потоки, перенаправление потоков, конвейер
- Настройка языка и региональных стандартов в Ubuntu Server/Debian
- Используем APT Pinning для закрепления пакетов в Debian и Ubuntu
- Linux — начинающим. Что такое Load Average и какую информацию он несет
- Обновляем снятый с поддержки дистрибутив Ubuntu
- Linux — начинающим. Обновление Debian до следующего выпуска
- Осваиваем эффективную работу в Midnight Commander
- Linux — начинающим. Что такое пространства подкачки и как они работают
- Linux — начинающим. Screen — многозадачность в терминале и ни единого разрыва!
- Linux — начинающим. Как узнать температуру процессора и накопителей
- Linux — начинающим. Как получить информацию об оборудовании ПК
- Linux — начинающим. Установка и первоначальная настройка Debian 11 для сервера
Помогла статья? Поддержи автора и новые статьи будут выходить чаще:

Или подпишись на наш Телеграм-канал:
Как считается Load Average
Недавно, во время собеседования в одну крупную компанию мне задали простой вопрос, что такое Load Average. Не знаю, на сколько правильно я ответил, но лично для себя пришло осознание, что точного ответа я на самом деле и не знаю.
Большинство людей наверняка знают, что Load Average — это среднее значение загрузки системы за некоторый период времени (1, 5 и 15 минут). Так же можно узнать некоторые подробности из данной статьи, про то, как этим пользоваться. В большинстве случаев этих знаний достаточно для того, что бы по значению LA оценивать загрузку системы, но я по специальности физик, и когда я вижу «среднее за промежуток времени» мне сразу становится интересна частота дискретизации на данном промежутке. А когда я вижу термин «ожидающие ресурсов», становится интересно, каких именно и сколько времени надо ждать, а так же сколько тривиальных процессов надо запустить, что бы получить за короткий промежуток времени высокий LA. И главное, почему ответы на эти вопросы не дает 5 минут работы с гуглом? Если вам данные тонкости так же интересны, добро пожаловать под кат.
Что-то здесь не так.
Для начала определимся с тем, что мы знаем. В общем виде Load Average это среднее количество ожидающих ресурсов ЦПУ процессов за один из трех промежутков времени. Так же нам известно, что это значение в нормальном состоянии находится в диапазоне от 0 до 1, и единица соответствует 100% загрузке одноядерной системы без перегруза. В дальнейшем я буду рассматривать систему как одноядерную, поскольку это проще и показательней.
Что здесь не так?
Во первых, все мы знаем, что среднее арифметическое нескольких величин равно сумме этих величин, деленной на их количество. Из той информации, что у нас есть абсолютно непонятно это самое количество. Если мы считаем ожидающие процессы в течении всей минуты, то среднее значение будет равно количеству процессов за минуту, деленному на единицу. Если будем считать каждую секунду — то и количество процессов в каждом подсчете уменьшится с диапазоном, и делить будем на 60. Таким образом чем выше частота дискретизации при наборе данных, тем меньшее среднее значение мы получим.
Во вторых что значит «ожидающий ресурсов процесс»? Если мы запустим большое количество быстрых процессов разом, то все они встанут в очередь, и по логике на короткий промежуток времени LA должен вырасти до совершенно неприемлемых величин, и при продолжительном мониторинге должны наблюдаться постоянные скачки, чего, в нормальной ситуации, нет.
В третьих, одноядерная система при 100% загрузке должна давать Load Average равный 1. Но здесь нет никакой зависимости от параметров этого ядра, хотя количество процессов может отличаться в разы. Данный вопрос может быть снят либо корректным определением «ожидающего ресурсов процесса», либо наличием какой-то нормировки на параметры ядра.
Литература
Найти ответы на поставленные вопросы оказалось не так уж и сложно. Правда только на английском языке, и не все так сходу стало понятно. Конкретно были найдены две статьи:
«Examining Load Average»
«UNIX Load Average»
Пользователь Rondo так же предложил вторую часть статьи с более подробным рассмотрением математического аппарата: «UNIX Load Average. Part 2»
А так же небольшой тест для тех, кто и так все понимает, указанный во второй статье.
Интересующимся я бы советовал прочитать обе статьи, хотя в них описаны очень близкие вещи. В первой описывается в общем виде много разных интересных подробностей работы системы, а во второй более подробно разбирается непосредственно расчет LA, приводятся примеры с нагрузкой и комментарии специалистов.
Немного ядерной магии
Из данных материалов можно узнать, что каждому вызываемому процессу дается ограниченный промежуток времени на использование CPU, в стандартной архитектуре intel этот промежуток равен 10мс. Это целая сотая доля секунды и в большинстве случаев процессу столько времени не нужно. Однако, если какой-то процесс использовал все отведенное ему время, то вызывается аппаратное прерывание и система возвращает себе управление процессором. Помимо этого каждые 10мс увеличивая счетчик тиков (jiffies counter). Данные тики считаются с момента запуска системы и каждые 500 тиков (раз в 5 секунд) рассчитывается Load Average.
Код непосредственно расчета находится в ядре в файле timer.c (код приведен для версии 2.4, в версии 2.6 все это несколько рассредоточено, но логика не изменилась, дальше, надеюсь, тоже существенных изменений нет, но, честно говоря, последние релизы не проверял):
646 unsigned long avenrun[3]; 647 648 static inline void calc_load(unsigned long ticks) 649 < 650 unsigned long active_tasks; /* fixed-point */ 651 static int count = LOAD_FREQ; 652 653 count -= ticks; 654 if (count < 0) < 655 count += LOAD_FREQ; 656 active_tasks = count_active_tasks(); 657 CALC_LOAD(avenrun[0], EXP_1, active_tasks); 658 CALC_LOAD(avenrun[1], EXP_5, active_tasks); 659 CALC_LOAD(avenrun[2], EXP_15, active_tasks); 660 >661 > Как видно, рассчитываются по очереди те самые три значения LA, однако не указано, что именно считается, и как именно считается. Это тоже не проблема, код функции count_active_tasks() находится в том же файле, чуть выше:
625 static unsigned long count_active_tasks(void) 626 < 627 struct task_struct *p; 628 unsigned long nr = 0; 629 630 read_lock(&tasklist_lock); 631 for_each_task(p) < 632 if ((p->state == TASK_RUNNING || 633 (p->state & TASK_UNINTERRUPTIBLE))) 634 nr += FIXED_1; 635 > 636 read_unlock(&tasklist_lock); 637 return nr; 638 > А CALC_LOAD лежит в sched.h вместе с несколькими интересными константами:
61 #define FSHIFT 11 /* nr of bits of precision */ 62 #define FIXED_1 (1<>= FSHIFT;
Из всего вышеперечисленного можно сказать, что раз в 5 секунд ядро смотрит, сколько всего процессов находится в состоянии RUNNING и UNINTERRUPTIBLE (кстати в других UNIX системах это не так) и для каждого такого процесса увеличивает счетчик на FIXED_1, что равняется 1
49 /* 50 * These are the constant used to fake the fixed-point load-average 51 * counting. Some notes: 52 * - 11 bit fractions expand to 22 bits by the multiplies: this gives 53 * a load-average precision of 10 bits integer + 11 bits fractional 54 * - if you want to count load-averages more often, you need more 55 * precision, or rounding will get you. With 2-second counting freq, 56 * the EXP_n values would be 1981, 2034 and 2043 if still using only 57 * 11 bit fractions. 58 */
Немного ядерного распада

Нет, тут не распадается ядро системы, просто формула CALC_LOAD, по которой считается Load Average основана на законе радиоактивного распада, или просто экспоненциального затухания. Данный закон есть не что иное, как решение дифференциального уравнения , то-есть каждое новое значение рассчитывается из предыдущего и скорость уменьшения количества элементов напрямую зависит от количества элементов.
Решением данного дифференциального уравнения является экспоненциальный закон:
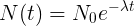
Фактически Load Average не является средним значением в обычном понимании среднего арифметического. Это дискретная функция, периодически рассчитываемая с момента запуска системы. При этом значение функции есть количество отрабатывающих в системе процессов в условиях экспоненциального затухания.
Такую конструкцию мы наблюдаем, переписав расчетную часть CALC_LOAD математическим языком:
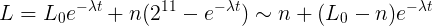

2^11 для нас в данному случае равносильно единице, мы ее зафиксировали изначально и добавляли везде, количество новых процессов так же рассчитывается в этих величинах. А , где T — интервал измерения (1, 5 или 15 минут).
Стоит заметить, что при фиксированном временном интервале и фиксированном времени между измерениями значения экспоненты вполне могут быть посчитаны заранее и использоваться как константа, что в коде и делается. Последняя операция — смещение вправо на 11 бит дает нам искомое значение Load Average с отбрасыванием нижних порядков.
Выводы
Теперь, понимая, как расчитывается LA можно попробовать ответить на вопросы, поставленные в начале статьи:
1) Среднее значение не является средним арифметическим, а есть среднее значение функции, которая рассчитывается каждые 5 секунд с момента старта системы.
2) «Ожидающими ресурсов CPU» считаются все процессы, находящиеся в состоянии RUNNING и UNINTERRUPTIBLE. А существенных скачков Load Average при продолжительном мониторинге мы не наблюдаем, поскольку затухающая экспонента играет роль сглаживающей функции (хотя при рассмотрении периода в 1 минуту их можно заметить).
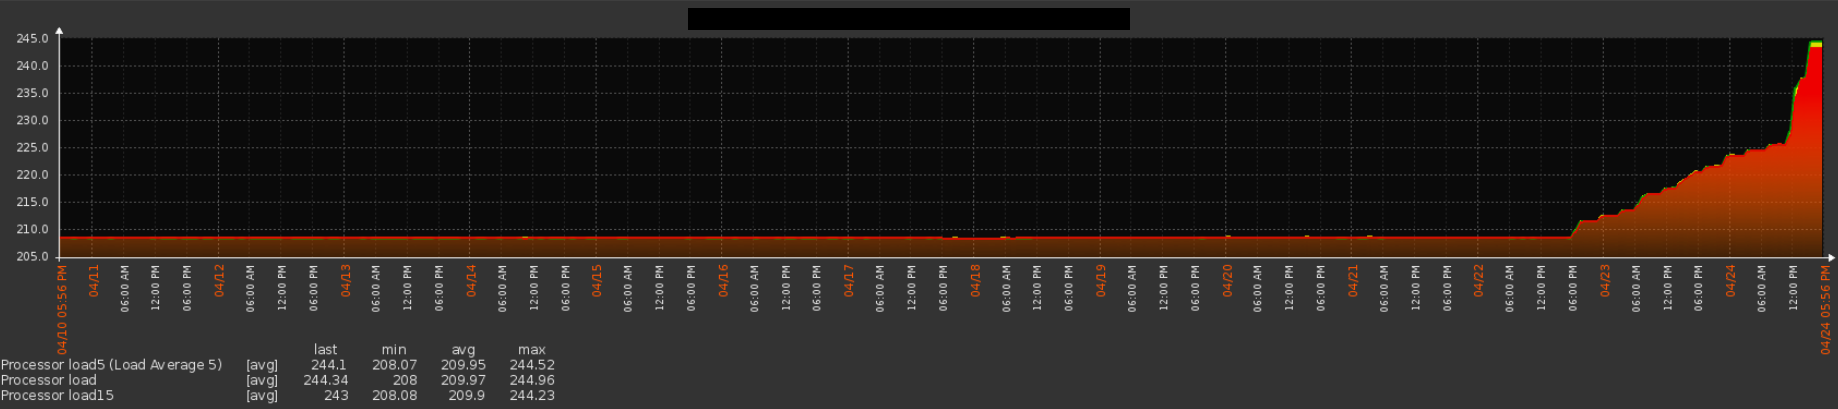
3) А вот тут один из самых интересных выводов. Дело в том, что указанная выше функция Load Average при любых значениях n монотонно возрастает к этому значению, если же n
вот такое
Однако помимо ответов на имевшиеся изначально вопросы разбор кода ставит и новые. Например, применима ли затухающая экспонента к сокращению числа ожидающих процессов? Если мы рассматриваем радиоактивный распад, то его скорость ограничена лишь количеством ядер, в нашем же случае, при большом количестве процессов все все упрется в пропускную способность CPU. Так же, если сравнить полученную формулу с экспоненциальным законом, становится видно, что , где T — продолжительность интервала набора данных (1, 5 или 15 минут). Таким образом разработчики ядра считают, что скорость уменьшения Load Average обратно пропорциональна продолжительности измерений, что несколько неочевидно, по крайней мере для меня. Ну и не сложно смоделировать ситуации, когда огромные значения LA не будут реально отображать загрузку системы, или наоборот.
В конечном счете складывается впечатление, что для расчета Load Average была выбрана сглаживающая функция, максимально быстро уменьшающая свое значение, что в целом логично для получения конечно числа, но не отображает реально происходящего процесса. И если кто-нибудь мне объяснит, почему именно экспонента и почему именно в таком виде, буду весьма признателен.
- load average
- linux kernel
- Системное администрирование
- *nix