. и кое-что о компьютерах.
Вот примерно так часто появляются темы на форумах. Почему это чушь, и почему объём памяти совсем не так уж и важен — я подробнее писал об этом вот здесь. Если коротко –то не в памяти дело, вернее, не только в памяти.
Но объём её всё равно важен. Хотя бы потому, что его указывают в системных требованиях к играм. И пусть эти “системные требования” – часто сильно усреднённая штука, но цифры там вполне конкретные, и они хоть как-то показывают, какими примерно характеристиками должен обладать компьютер для того, чтоб эту игру запускать. Насколько важно количество видеопамяти-можно узнать только в сравнении, по тестам; их много в интернете. Один из примеров- есть здесь, это всего лишь ссылка, найденная за пару секунд в Google. Но даже из неё ясно, что видеокартам среднего уровня (а мобильные в большинстве своём относятся именно к таким, и ниже) практически всё равно, 512мб или 1гб памяти на неё есть- это не даёт сколько-нибудь ощутимых преимуществ, отличающихся от обычной погрешности в таких тестах.
Какие бы не были системные требования игры или программы, может возникнуть необходимость проверить, а сколько же в реальности игра этой самой видеопамяти потребляет. Хотя бы для того, чтоб не ломиться сразу в интернет с вопросом, на что поменять видеокарту в ноутбуке потому,что у неё – “всего” 512мб на борту.
Путаницу вносит и тот факт, что на ноутбках дискретные карты умеют оперировать двумя типами памяти. Первый –это собственная память, собственный чип видеокарты, относительно небольшого (в сравнении с следующим типом) объёма. Второй- это т.н. “разделяемая память” (“shared memory”), память, которая выделяется видеокарте из оперативной по необходимости (повторюсь, я про это писал здесь.) Значит, если у видеокарты 512мб собственной памяти, то при требованиях игры в 1гб она вообще не пойдёт? Или всё-таки будет использована shared memory, а её много, и с запасом больше (пара гигабайт?)
Вот для этого и нужен мониторинг и средство, которое позволило бы определить, сколько ресурсов ваша любимая игра “съедает”.
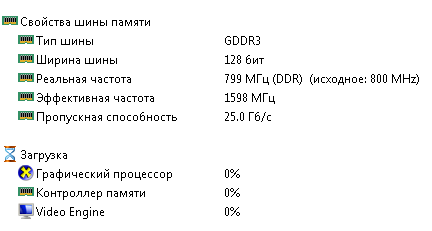
Стандартные тестовые пакеты вроде Aida и подобных такой возможности не дают- ну или вернее, дают её очень ненаглядным и неудобным способом. Вот так это выглядит в Aida:
Отображение загрузки в процентах тут позволяет увидеть только то, что творится в данную секунду, не давая возможности мониторинга. Т.е. запустив игру и свернув её, вы увидите тут не реальные текущие данные, а результат сворачивания, когда большая часть ресурсов не используется.
Чтоб было хорошо- используем одну из лучших утилит всех времён и народов – Process Explorer (а здесь — страница на русском, но утилита всё равно на английском).
Описывать все её возможности смысла нет, это сделано многократно в интернете. Сейчас нас интересует возможность проверки нагрузки на видео.
После запуска программы в верхней части окна будут видны графики, показывающие различную текущую информацию о процессах в системе, 6-ой слева (или 2-ой справа) нас и интересует. Двойной щелчёк по нему открывает окно, относящееся к видеоподсистеме. Туда же можно попасть, выбрав пункт “System Information” из меню “View”.
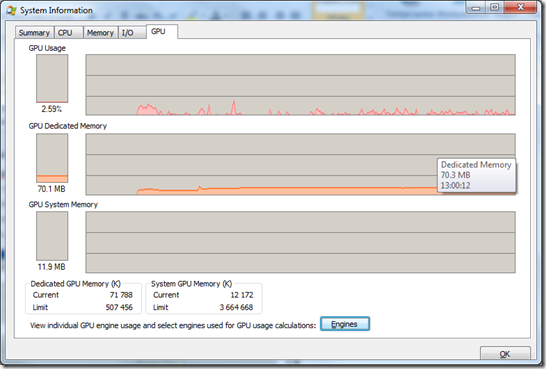
Здесь GPU Usage— это загрузка видеочипа, GPU Dedicated memory –использование собственной памяти видеокарты, и GPU System Memory— количество используемой оперативной. На скриншоте выше- ситуация, когда запущено несколько программ и включен Aero, на скриншоте ниже- тот же набор программ, но Aero выключен.

Происходит такое потому, что при включении Aero прорисовку интерфейса Windows берёт на себя видеокарта, а при отключении –как и в ХР, процессор. Соответственно изменяется и нагрузка на процессор. Кстати, с оперативной памятью системы – такая же ситуация, со включенным Aero система использует примерно на 50мб больше оперативки, чем без него.
Как посмотреть, насколько были задействованы ресурсы видеокарты во время игры? Запускаем Process Explorer, сворачиваем, запускаем игру. На графике отображается ~5 минут событий, обновление графика –каждую секунду.
Можно изменить время обновления графика, от полусекунды до 10-и секунд (меню “View”-“Update interval”, относится к данным во всей программе). Есть смысл ставить 10 секунд, получив усреднённые данные за больший период времени.
Для примера – в Fallout3 на максимальных настройках качества ресурсы видеочипа у меня (это видеокарта geforce 9600m gt ddr3 512mb в ноутбуке с 4gb опертивки и процессором core3duo P8600) использовались примерно наполовину, а загрузка видеопамяти составляла не более 400 мегабайт.
nvidia-smi Volatile GPU-Utilization explanation?
I know that nvidia-smi -l 1 will give the GPU usage every one second (similarly to the following). However, I would appreciate an explanation on what Volatile GPU-Util really means. Is that the number of used SMs over total SMs, or the occupancy, or something else?
+-----------------------------------------------------------------------------+ | NVIDIA-SMI 367.48 Driver Version: 367.48 | |-------------------------------+----------------------+----------------------+ | GPU Name Persistence-M| Bus-Id Disp.A | Volatile Uncorr. ECC | | Fan Temp Perf Pwr:Usage/Cap| Memory-Usage | GPU-Util Compute M. | |===============================+======================+======================| | 0 Tesla K20c Off | 0000:03:00.0 Off | 0 | | 30% 41C P0 53W / 225W | 0MiB / 4742MiB | 96% Default | +-------------------------------+----------------------+----------------------+ | 1 Tesla K20c Off | 0000:43:00.0 Off | 0 | | 36% 49C P0 95W / 225W | 4516MiB / 4742MiB | 63% Default | +-------------------------------+----------------------+----------------------+ +-----------------------------------------------------------------------------+ | Processes: GPU Memory | | GPU PID Type Process name Usage | |=============================================================================| | 1 5193 C python 4514MiB | +-----------------------------------------------------------------------------+ 71k 34 34 gold badges 194 194 silver badges 272 272 bronze badges
asked Dec 2, 2016 at 17:31
user3813674 user3813674
2,553 2 2 gold badges 16 16 silver badges 26 26 bronze badges
For those wondering, SM means Streaming Multiprocessor, and it is explained here.
May 23, 2017 at 14:25
Volatile is from the top row, as in Volatile Uncorr. ECC — which sounds like a serious memory error. You have 0 of them in the output above.
Jun 7, 2020 at 18:01
2 Answers 2
It is a sampled measurement over a time period. For a given time period, it reports what percentage of time one or more GPU kernel(s) was active (i.e. running).
It doesn’t tell you anything about how many SMs were used, or how «busy» the code was, or what it was doing exactly, or in what way it may have been using memory.
The above claim(s) can be verified without too much difficulty using a microbenchmarking-type exercise (see below).
Based on the Nvidia docs, The sample period may be between 1 second and 1/6 second depending on the product. However, the period shouldn’t make much difference on how you interpret the result.
Also, the word «Volatile» does not pertain to this data item in nvidia-smi . You are misreading the output format.
Here’s a trivial code that supports my claim:
#include #include #include const long long tdelay=1000000LL; const int loops = 10000; const int hdelay = 1; __global__ void dkern() < long long start = clock64(); while(clock64() < start+tdelay); >int main(int argc, char *argv[]) < int my_delay = hdelay; if (argc >1) my_delay = atoi(argv[1]); for (int i = 0; i>>(); usleep(my_delay);> return 0; > On my system, when I run the above code with a command line parameter of 100, nvidia-smi will report 99% utilization. When I run with a command line parameter of 1000, nvidia-smi will report ~83% utilization. When I run it with a command line parameter of 10000, nvidia-smi will report ~9% utilization.
Although this answer is focused on GPU kernels, I have lately noticed that nvidia-smi will also report non-zero GPU utilization when for example cudaMemcpy operations are running (and nothing else). So the above description should be considered a description of reporting with respect to CUDA kernel activity.
And How to Improve It
GPU utilization refers to the percentage of a graphics card’s processing power being used at a particular time. Graphics Processing Units (GPUs) are specialized hardware components engineered to manage complex mathematical calculations necessary for rendering graphics and executing parallel computing tasks. Recently, GPUs have gained popularity for their ability to accelerate machine learning and deep learning processes.
This is part of a series of articles about Multi GPU.
- Why Is Monitoring GPU Utilization Important?
- ~ Improved Resource Allocation
- ~ Refining Performance
- ~ Saving Costs in Cloud Environments
- ~ Preventing Bottlenecks and Enhancing Workflows
- Reasons for Low GPU Utilization
- Monitoring and Improving GPU Utilization for Deep Learning
- GPU Utilization with Run:ai
Why Is Monitoring GPU Utilization Important?
Keeping track of GPU utilization is essential for several reasons:
Improved Resource Allocation
Graphics cards, like NVIDIA’s Tesla series or AMD Radeon Instinct, are specifically designed to tackle computationally demanding tasks, such as deep learning algorithms. However, these GPUs can be costly investments for organizations. Monitoring their utilization enables data scientists and machine learning engineers to identify underused resources and reallocate workloads more effectively across available hardware.
Refining Performance
One crucial aspect of optimizing deep learning models is tweaking parameters like batch sizes, which directly influence training duration and memory usage. Tracking GPU memory usage helps determine if a model needs smaller batch sizes or if it can take advantage of larger ones without triggering out-of-memory errors.
Saving Costs in Cloud Environments
In cloud-based environments where users are billed for compute resources by the hour or minute (e.g., AWS EC2 instances), monitoring GPU usage becomes even more vital. Ensuring that your organization only pays for what it needs means reducing idle times while maximizing throughput during active periods.
Preventing Bottlenecks and Enhancing Workflows
Keeping an eye on GPU usage can help identify data pipeline bottlenecks, such as slow I/O activities or insufficient CPU resources. Addressing these issues can substantially boost overall performance and efficiency.
It also allows teams to optimize workflows by pinpointing tasks that are better suited for GPUs and tasks that should be assigned to CPUs or other specialized hardware accelerators.
Related content: Read our guide to GPU scheduling
Reasons for Low GPU Utilization
Low GPU utilization can occur due to a number of factors. Here are some common reasons:
- CPU bottleneck: The CPU may not be able to supply data fast enough to the GPU, causing the GPU to idle while it waits for data. This is one of the most common causes of low GPU utilization. Optimizing CPU code and using asynchronous data transfers can help to mitigate this.
- Memory bottleneck: If your application requires a large amount of memory bandwidth, the GPU may spend a lot of time waiting for data to be transferred to or from memory. You can try to optimize memory access patterns to reduce this bottleneck.
- Inefficient parallelization: GPUs work best when they can execute many threads in parallel. If your application is not properly parallelized, or if the workload cannot be evenly distributed across all the GPU cores, this could lead to low GPU utilization.
- Low compute intensity: Some tasks may not be very computationally intensive, and may not fully utilize the GPU’s processing power. If the task involves a lot of conditional logic or other operations that are not well-suited to parallel processing, the GPU may not be fully utilized.
- Use of single precision vs. double precision: GPUs often have different performance characteristics for single-precision and double-precision calculations. If your code uses double-precision calculations, but the GPU is optimized for single-precision, this could lead to lower utilization.
- Synchronization and blocking operations: Certain operations can block the GPU and cause it to idle. This includes explicit synchronization operations, as well as operations like memory allocation or certain types of memory transfer.
Investigating these factors can help you identify why your GPU utilization is low, and can guide you in optimizing your code and system setup to improve utilization.
Monitoring and Improving GPU Utilization for Deep Learning
Effectively monitoring and controlling GPU utilization is essential for deep learning applications, as it significantly influences model performance.
Various tools and techniques can assist you in monitoring GPU usage, optimizing resource distribution, and ultimately reducing training times. For example, NVIDIA System Management Interface (nvidia-smi), a command-line utility included with NVIDIA graphics card drivers, offers real-time data on multiple GPU aspects, such as temperature, power usage, memory consumption, and more.
Nvidia-smi and similar tools allow users to efficiently monitor GPU resources while executing deep learning tasks:
- Adjusting batch sizes: One method to boost GPU utilization is by modifying the batch size during model training. Larger batch sizes may increase memory consumption but can also improve overall throughput. Testing various batch sizes can help find the ideal balance between memory usage and performance.
- Mixed precision training: Another strategy for enhancing GPU efficiency is mixed precision training, which uses lower-precision data types like float16 instead of float32 when performing calculations on Tensor Cores. This method decreases both computation time and memory demands without compromising accuracy.
- Distributed training: Spreading your workload over multiple GPUs or even multiple nodes can further improve resource usage by parallelizing computations. Frameworks such as TensorFlow’s MirroredStrategy or PyTorch’s DistributedDataParallel simplify the implementation of distributed training approaches in your projects.
Besides these techniques, specialized solutions like Run:ai can aid in automating resource management and optimizing GPU usage across your entire infrastructure.
GPU Utilization with Run:ai
The Run:ai platform allows you to utilize your GPU compute, so no compute is left idle. The easy to navigate dashboard gives you the ability you to set policies and rules, and schedule, allocate, and fraction the compute you’re already using, optimizing your resources, and saving the need to purchase more GPUs to run and train your AI models.
Потребление ресурсов

Чтобы узнать, сколько программа потребляет ОЗУ и насколько эффективно загружает процессорные ядра, можно использовать методы, описанные ниже.
Во время работы программы
Предварительно необходимо выяснить, на каких именно узлах работает задача. Это делается командой ‘qstat -f XXXX‘, где XXXX — номер выполняющейся задачи. Выделенные задаче узлы будут отображаться в строке ‘exec_host’:
user01@clu:~> qstat -f 389182
. exec_host = cn225/0*4+cn226/0*4+cn227/0*4+cn228/0*4 .
В данном случае задача работает на узлах cn225, cn226, cn227 и cn228. ‘0*4’ означает, что на каждом узле выделено по 4 ядра.
Метод 1
Данный способ наиболее нагляден, но применим только в том случае, если вычислительный узел монопольно занят одной задачей.
Открыть веб-интерфейс Ganglia. В левом верхнем углу в поле ‘Choose a Source’ выбрать поле, соответствующее модели используемых узлов:
BL2x220c-G6 для 8-ядерных, с именами cn101-cn196
BL2x220c-G7 для 12-ядерных, с именами cn201-cn296
SL390s-G7 для узлов с GPU, sl001-sl012
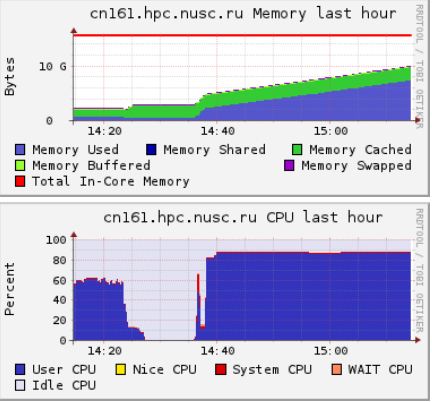
В появившемся рядом поле ‘Choose a Node’ выбрать интересующий узел. Будет отображена статистика использования ресурсов за некоторое прошедшее время. В первую очередь надо обращать внимание на использование Memory и CPU. Например, из приведённой ниже картинки видно, что задача, запустившаяся около 14:36, достаточно быстро загрузила все ядра до 90% и стабильно держит нагрузку на этом уровне, а потребление оперативной памяти с момента запуска постепенно увеличивается, и на данный момент (15:15) составляет около 9 ГБ:
Для обновления графиков необходимо нажать кнопку ‘Get Fresh Data’ в правом верхнем углу.
Метод 2
Зайти на используемый узел с помощью команды ‘ssh‘:
user01@clu:~> ssh cn225
user01@cn225:~>
Подобным образом можно зайти только на тот узел, на котором уже выполняется Ваша программа, запущенная планировщиком. Если же зайти на какой-то другой узел, то ssh-сессия будет принудительно закрыта в течении нескольких секунд.
Запустить команду ‘top‘:
user01@cn225:~> top
top - 22:56:25 up 1 day, 10:06, 1 user, load average: 4.43, 4.44, 4.45 Tasks: 349 total, 5 running, 344 sleeping, 0 stopped, 0 zombie Cpu(s): 31.8%us, 0.4%sy, 0.0%ni, 67.6%id, 0.2%wa, 0.0%hi, 0.0%si, 0.0%st Mem: 24684348k total, 23334268k used, 1350080k free, 119680k buffers Swap: 33559776k total, 0k used, 33559776k free, 7100712k cached PID USER PR NI VIRT RES SHR S %CPU %MEM TIME+ COMMAND 25415 user01 20 0 3835m 3.7g 15m R 101 15.6 293:43.08 fluent_mpi.13.0 25417 user01 20 0 3776m 3.6g 15m R 101 15.3 293:58.96 fluent_mpi.13.0 25416 user01 20 0 3945m 3.8g 15m R 99 16.0 294:04.56 fluent_mpi.13.0 25418 user01 20 0 3961m 3.8g 15m R 99 16.1 293:17.68 fluent_mpi.13.0 9300 root 20 0 27060 8316 1168 S 2 0.0 5:37.87 pbs_mom 1 root 20 0 1064 412 348 S 0 0.0 0:01.92 init 2 root 15 -5 0 0 0 S 0 0.0 0:00.02 kthreadd .
В данном случае видно, что:
Работают 4 процесса пользователя user01, каждый из которых потребляет около 3.7 ГБ ОЗУ (столбец RES) и полностью загружает одно ядро (столбец %CPU).
Всеми процессами (включая операционную систему) на узле суммарно используется 23334268 КБ ОЗУ из имеющихся 24684348 КБ.
Виртуальная память (SWAP) на узле не используется.
Полное потребление памяти, включая виртуальную, отображается в столбце VIRT
Если число в столбце RES не имеет суффикса g или m, то это значение в килобайтах.
Чтобы прервать работу утилиты top, необходимо нажать Ctrl-C
Использование GPU
При выполнении вычислений на графических сопроцессорах cтепень загруженности GPU и памяти видеокарты можно узнать с помощью утилиты ‘nvidia-smi‘. Для этого необходимо:
Определить используемый задачей узел и GPU.
Командой ‘ssh’ зайти с интерфейсного сервера на соответствующий узел и выполнить следующую команду, заменив ‘X’ на идентификатор нужного GPU (или нескольких GPU, через запятую):
nvidia-smi --query-gpu=utilization.gpu,utilization.memory,memory.free,memory.used --format=csv -i X
При использовании узлов в очереди teslaq в качестве идентификатора GPU можно использовать его порядковый номер (от 0 до 2), определяемый из имени виртуального узла. Например, если интересует нагрузка на GPU задачей с номером 3437445, запросившей два ngpus:
Чтобы узнать выделенные задаче виртуальные узлы, выполнить на интерфейсном сервере:
qstat -f 3437445|tr -d '\n'' ''\t'|sed 's/Hold_Types.*//'|sed 's/.*exec_vnode=//'|tr -d \(\)|tr + '\n'|sed 's/:.*//'|sort
Допустим, эта команда выведет:
sl003[0] sl003[2]
Т.е. задача иcпользует GPU с номерами 0 и 2 на узле sl003.
Выполнить на интерфейсном сервере команду:
ssh sl003 nvidia-smi --query-gpu=utilization.gpu,utilization.memory,memory.free,memory.used --format=csv -i 0,2
При использовании очереди a6500g10q порядковый номер GPU не является уникальным идентификатором т.к. для каждой из работающих задач доступные GPU нумеруются последовательно, начиная с ноля. Вместо этого можно использовать идентификатор шины PCI:
Добавить в начало скрипта для qsub такую команду:
nvidia-smi --query-gpu=pci.bus_id --format=csv,noheader > $PBS_O_WORKDIR/$PBS_JOBID.id
В результате после запуска задачи в рабочей директории появится файл с именем вида ‘95054.vm-pbs.id’, содержащий что-то вроде ‘00000000:15:00.0’ (или несколько таких строк, если было запрошено несколько GPU).
Выполнить команду вида:
ssh a6500g10 nvidia-smi --query-gpu=utilization.gpu,utilization.memory,memory.free,memory.used --format=csv -i 00000000:15:00.0
В результате на экран будет выведено примерно такое:
utilization.gpu [%], utilization.memory [%], memory.free [MiB], memory.used [MiB] 33 %, 0 %, 1735 MiB, 30775 MiB
Обращаем внимание, что ‘utilization.memory’ — это интенсивность работы с памятью карты, а не степень её заполненности.
Может быть полезно выполнить ‘man mvidia-smi’ и изучить возможности утилиты. Например, можно запросить вывод статистики каждые 10 секунд, добавив команде параметр ‘-l 10’
После завершения программы
Выполнить команду ‘tracejob XXX‘, где ‘XXX’ — номер задачи. Эта команда анализирует логи PBS и выводит информацию, связанную с работой указанной задачи. По умолчанию обрабатываются данные только за последний день. Если задача закончилась несколько дней назад или Вы хотите получить данные, начиная с момента постановки задачи в очередь, то надо дополнительно указать параметр ‘-n ZZZ‘, где ‘ZZZ’ — количество дней, прошедших с данного момента, логи за которые должна проанализировать команда.
Пример: запрос информации по задаче с номером 482685 за два прошедших дня:
tracejob -n 2 482685
. 11/19/2013 06:05:04 A user=user01 group=users project=_pbs_project_default jobname=runs queue=bl2x220g7q ctime=1384777907 qtime=1384777907 etime=1384777907 start=1384777908 exec_host=cn263/0 exec_vnode=(cn263:mem=4194304kb:ncpus=1) Resource_List.mem=4gb Resource_List.ncpus=1 Resource_List.nodect=1 Resource_List.place=pack Resource_List.qlist=bl2x220g7q Resource_List.select=1:mem=4gb:ncpus=1:qlist=bl2x220g7q Resource_List.walltime=100:00:00 session=10647 end=1384815904 Exit_status=271 resources_used.cpupercent=98 resources_used.cput=10:33:16 resources_used.mem=1321292kb resources_used.ncpus=1 resources_used.vmem=2144544kb resources_used.walltime=10:33:17 run_count=1
Здесь видно, в частности, что задача:
Запросила 1 ядро (Resource_List.ncpus) и 4 ГБ ОЗУ (Resource_List.mem)
Но ОЗУ использовалась крайне неэффективно: resources_used.mem=1321292kb, т.е. примерно 1.26 ГБ из 4 ГБ запрошенных. Что означает, что 2.5 ГБ из зарезервированных PBS под эту задачу, не использовались и при этом были недоступны другим пользователям.
Время работы команды ‘tracejob’ зависит от временного интервала, за который запрашивается информация.
Если с момента завершения задачи прошло не очень много времени, то можно также открыть веб-интерфейс Ganglia и посмотреть на графики работы. Однако, чем больше прошло времени, тем сложнее будет по графикам определить период работы задачи.
Использование виртуальной памяти
В случае, если необходимо использовать больше ОЗУ, чем имеется у компьютера, операционная система сохраняет данные из каких-то неиспользуемых в данный момент областей оперативной памяти на жесткий диск в специальный файл (файл подкачки) или специальный раздел диска, обобщённо называемые ‘swap’ (английское ‘обмен’). Освободившаяся оперативная память используется по назначению. В случае, если потребуются данные, перенесённые в swap, то происходит аналогичная операция — часть данных из ОЗУ переносится на диск, а нужные данные с диска возвращаются в оперативную память. Подобный метод позволяет операционной системе и программам работать так, как будто на компьютере больше оперативной памяти, чем на самом деле. Поэтому такая память называется виртуальной.
К сожалению, скорость передачи данных у жесткого диска существенно меньше, чем у микросхем оперативной памяти. Поэтому интенсивное использование swap сильно замедляет работу.
Рассмотрим типичные графики, полученные при помощи системы Ganglia с сервера, на котором работает задача, потребившая всю оперативную память (обозначена на первом графике синим) и интенсивно использующая swap (фиолетовый):
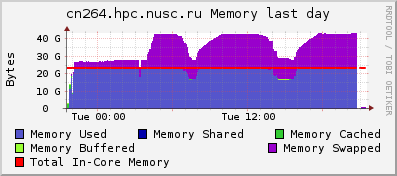
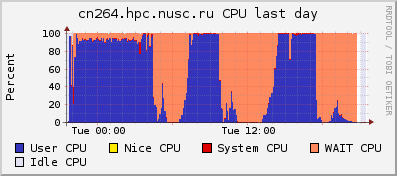
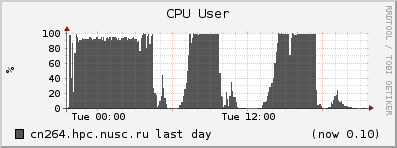
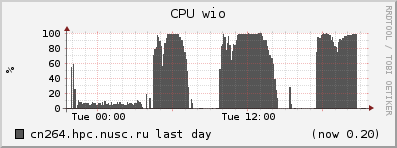
Видно, что в те моменты, когда потребление swap увеличивается, процессор вместо выполнения прикладных задач (‘User CPU’, загрузка процессора пользовательскими программами) простаивает в ожидании данных (‘Wait CPU’ и ‘CPU wio’; wio = wait in/out, ожидание ввода/вывода). То есть данная программа почти половину времени не работает, а ждёт обмена данными с жёстким диском. И если бы у сервера было больше оперативной памяти, программа работала бы почти в два раза быстрее.
Поэтому рекомендуется отслеживать потребление памяти вашими задачами и при необходимости что-то менять:
В случае, если программа пишется вами, в первую очередь надо подумать об оптимизации кода с целью уменьшения потребления ОЗУ.
Если известно, что при распараллеливании задачи каждый процесс, загружающий одно ядро, требует определённое количество ОЗУ и оно больше, чем имеется у сервера, то может иметь смысл занимать сервер полностью, но задействовать не все ядра. Например: у сервера 12 ядер и 24 ГБ ОЗУ, т.е. 2 ГБ на ядро; а задаче необходимо 3 ГБ на процесс. В таком случае можно занять сервер полностью (запросить 12 ядер) но задействовать только 24/3 = 8 ядер, запустив 8 процессов. Хотя более правильным будет позапускать задачу с использованием разного количества ядер и найти компромиссный вариант, обеспечивающий максимальное использование процессора.
Перенести запуск задач на сервера другого типа, имеющие больше ОЗУ либо больше ОЗУ на одно ядро.
Следует однако отметить, что само по себе использование виртуальной памяти и количество данных, находящихся в swap, не критичны для быстродействия. Если данные просто перенеслись на диск и долгое время никому не требовались, то и больших задержек не возникло. Гораздо важнее интенсивность работы с swap — как часто происходят обращения к жёсткому диску для чтения или записи. К сожалению, количества таких обращений на графиках Ganglia нет.
Ниже приведены графики задачи, которой использование виртуальной памяти не вредит — хотя в swap находится уже 24 ГБ данных, процессор всё равно загружен на 90%. Другое дело, что виртуальная память не бесконечна и если она закончится, то такая задача прервётся. Скорее всего, для такой задачи будет более правильным сразу сохранять в файл полученные результаты и освобождать память.