Датацентрический и моделецентрический подходы в машинном обучении
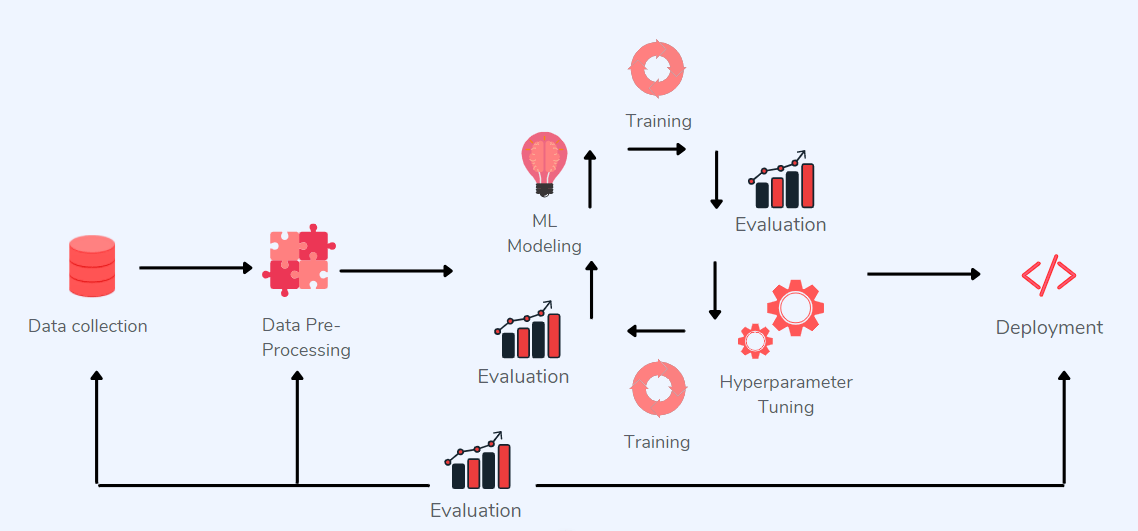
Код и данные — фундамент ИИ-системы. Оба эти компонента играют важную роль в разработке надёжной модели, но на каком из них следует сосредоточиться больше? В этой статье мы сравним методики, ставящие в центр данные, либо модель, и посмотрим, какая из них лучше; также мы поговорим о том, как внедрять датацентрическую инфраструктуру.
Моделецентрическая методика
При моделецентрической методике выполняются экспериментальные исследования для повышения качества модели ML. Из широкого спектра возможностей выбираются наилучшая архитектура модели и процесс обучения.
- При таком подходе данные остаются неизменными, совершенствуется код или архитектура модели.
- Работа над кодом — основная цель этой методики.
Моделецентрические тенденции в мире ИИ
На сегодняшний день большинство ИИ-приложений моделецентричны; вероятно, причина этого заключается в том, что сектор разработки ИИ внимательно следит за научными исследованиями моделей. По словам Эндрю Ына, более 90% исследовательских статей в этой предметной области моделецентрично, потому что сложно создать крупные массивы данных, которые могут стать общепринятыми стандартами. Из-за этого сообщество разработчиков ИИ полагает, что моделецентичное машинное обучение более перспективно. Основное внимание уделяется коду, а данные зачастую игнорируются и сбор данных считается единоразовым событием.
Датацентрическая методика
В эпоху, когда данные являются основой любого процесса принятия решений, датацентрическая (data-centric) компания может лучше соотносить свою стратегию с интересами партнёров, используя информацию, сгенерированную по итогам их работы. Благодаря этому результаты могут быть более точными, упорядоченными и прозрачными, что позволяет организации функционировать стабильнее.
- При таком подходе массивы данных систематически изменяются/совершенствуются для повышения точности ML-приложений.
- Работа над данными — основная цель такой методики.
Различия между data-driven и data-centric

Data-driven и data-centric
Многие люди часто путают методики data-centric и data-driven. Подход data-driven — это методология сбора, анализа и понимания данных. Иногда его называют «аналитикой». Подход data-centric сосредоточен на использовании данных для определения того, что вообще нужно создавать.
- Датацентрическая архитектура — это система, в которой данные являются основным и неотъемлемым ресурсом, а способы их использования меняются.
- Data-driven-архитектура — это создание технологий, навыков и среды при помощи переработки больших объёмов данных.
Датацентрический и моделецентрический подходы
Дата-саентистам и инженерам машинного обучения моделецентрический подход может казаться более удобным. Это понятно, ведь практические специалисты могут использовать свои знания для решения конкретной задачи. С другой стороны, никто не захочет тратить весь день на разметку данных, потому что это считается скучной работой.
В современном машинном обучении данные критически важны, однако разработчики ИИ их часто игнорируют или относятся к ним неправильно. В результате этого сотни часов тратятся на настройку модели на основе ошибочных данных. Это вполне может быть фундаментальной причиной низкой точности вашей модели, и это никак не связано с оптимизацией модели.
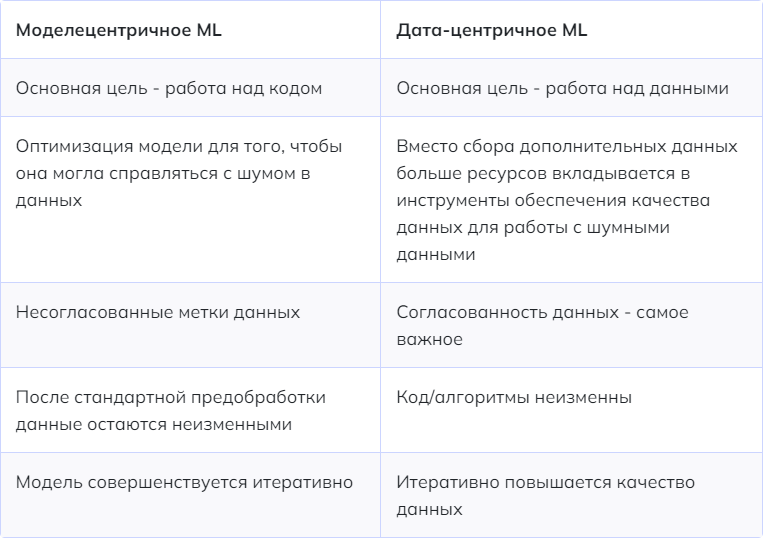
Необязательно полностью переходить на датацентрический подход, иногда важно сосредоточиться на модели и коде. Стоит проводить исследования и совершенствовать модели, но и данные тоже важны. Мы склонны не замечать важность данных и основное внимание уделяем модели. Лучше всего использовать гибридный подход, учитывающий и данные, и модель. В зависимости от способа использования можно уделять больше внимания данным и меньше модели, но учитывать обязательно нужно оба аспекта.
Потребность в датацентрической архитектуре
Моделецентрическое ML — это системы машинного обучения, в основном делающие упор на оптимизацию архитектур моделей и их параметров.

Моделецентрическое применение ML
Показанный на рисунке выше моделецентрический процесс подходит для некоторых отраслей, в частности, медиа и рекламного бизнеса, но ситуация меняется, когда дело касается здравоохранения или производства. В них можно столкнуться со следующими трудностями:
1. Потребность в высокоуровневой кастомизации
В отличие от медиа и рекламного бизнеса, производитель множества разных товаров не может использовать одну систему машинного обучения для распознавания брака во всём ассортименте продукции. Каждый изготавливаемый продукт требует отдельно обученной модели ML.
Медиа-компании могут позволить себе иметь свой собственный отдел ML, работающий над каждой задачей оптимизации, однако производственный бизнес, требующий множества ML-решений, не может пойти по тому же пути.
2. Важность больших массивов данных
В большинстве случаев у компаний нет большого количества размечанных данных, с которыми можно работать. Часто они вынуждены иметь дело с крошечными массивами данных, которые при моделецентрическом подходе обеспечивают неудовлетворительные результаты.
Эндрю Ын считает, что датацентрическое ML даёт бОльшую отдачу и продвигает идею революции в сообществе в сторону датацентричности. Он приводит пример задачи обнаружения дефектов в стали, в котором моделецентрическая методика не смогла повысить точность модели, а датацентрическая методика увеличила точность на 16%.
Данные чрезвычайно важны в исследованиях ИИ, а внедрение стратегии, отдающей приоритет получению высококачественных данных, критически необходимо — в конечном итоге, релевантные данные не только редки и шумны, но и процесс их получения очень дорог. Принцип заключается в том, что с ИИ нужно обращаться так же, как при подборе качественных материалов при строительстве дома. Данные нужно оценивать на каждом уровне, а не выбирать их один раз.
Датацентрический способ применения ML
Внедрение датацентрической инфраструктуры
При реализации датацентрической архитектуры данные необходимо рассматривать как фундаментальный ресурс, срок жизни которого будет больше, чем у приложений и инфраструктуры. При таком подходе требуется не единая база данных или репозиторий данных, а общее понимание данных и их единообразное описание. Датацентрическое ML упрощает обмен данными и их перемещение.
Так что же включает в себя датацентрическое машинное обучение? Какие существенные факторы следует учитывать при реализации датацентрического подхода?
1. Качество разметки данных
Разметка данных — это процесс присвоения данным одной или нескольких меток. Метки ассоциируются с конкретными значениями, присваиваемыми данным. Если неверно размечено существенное количество изображений, то результаты будут хуже, чем при использовании меньшего количества более точных данных.
В метках содержится подробная информация о содержимом и структуре массива данных, которая может включать в себя такие компоненты, как перечень типов данных, единиц измерения и временных интервалов, представленных в массиве. Наилучшим способом повышения качества данных является поиск несоответствий в метках и работа над инструкциями по разметке. Ниже мы подробнее расскажем о важности качества данных.
2. Аугментация данных
Аугментация данных — это задача анализа данных, включающая в себя создание обучающих примеров при помощи интерполяции, экстраполяции и других средств. Её можно использовать для добавления дополнительных данных обучения для ML или для создания синтетических изображений/кадров видео с различной степенью реализма. Она помогает увеличить количество релевантных данных, например, количества бракованных изделий, создавая данные, которые ваша модель в процессе обучения пока не видела.
Однако добавление данных не всегда является наилучшим вариантом. Устранение шумных данных, приводящих к высокой дисперсии, улучшает способность модели обобщать новые данные.
3. Конструирование признаков
Конструирование признаков (feature engineering) — процесс добавления в модель признаков при помощи изменения входящих данных, предшествующих знаний или алгоритмов. Оно используется в машинном обучении для повышения точности прогнозирующей модели.
Повышение качества данных включает в себя улучшение и входящих данных, и целевых/меток. Конструирование признаков критически важно для добавления признаков, которые могут и не существовать в «сыром» виде, но способны внести существенный вклад в обучение модели.
4. Контроль версий данных
В любом программном приложении важную роль играет контроль версий данных. Разработчикам необходимо устранять ошибки, сравнивая две версии и выявляя аспекты, которые больше не имеют ценности. Или же разработчики могут предотвратить появление бага, повторно внедрив конкретную версию данных. Управление доступом к массивам данных, а также к различным версиям каждого массива данных — это сложная и не защищённая от ошибок задача. Контроль версий данных — один из самых важных этапов в управлении данными, именно он позволяет отслеживать изменения (и добавление, и удаление) в массиве данных. Контроль версий упрощает совместную работу над кодом и управление массивами данных.
Также контроль версий упрощает управление конвейером ML от proof of concept до продакшена, на этом этапе на помощь приходят инструменты MLOps. Вы можете задаться вопросом, почему инструменты MLOps обсуждаются в контексте контроля версий данных? Потому что управление конвейерами данных — очень сложная задача в разработке приложений машинного обучения. Контроль версий обеспечивает воспроизводимость и надёжность. Вот лучшие платформы для контроля версий данных:
а) Neptune
Neptune — это хранилище метаданных для MLOps, разработанное для исследовательских и производственных групп. Оно создаёт общий центральный хаб для журналирования, хранения, отображения, упорядочивания, сравнения и запрашивания всех метаданных, сгенерированных на протяжении жизненного цикла машинного обучения. В контексте контроля версий данных при помощи Neptune можно выполнять следующие операции:
- Отслеживать версию массива данных в прогонах машинного обучения при помощи артефактов.
- Запрашивать версию массива данных из предыдущих прогонов, чтобы гарантировать, что вы выполняете обучение на одной версии массива данных.
- Упорядочивать метаданные версий массивов данных в Neptune UI.

Чтобы узнать больше о контроле версий данных в Neptune, см. примеры кода.
б) Weights & Biases
Weights & Biases (WandB) — это платформа, предоставляющая инструменты машинного обучения исследователям и командам, занимающимся глубоким обучением. WandB помогает в контроле экспериментов, контроле версий массивов данных и управлении моделями. При помощи WandB можно выполнять следующие операции:
- Использовать артефакты для контроля версий массивов данных и моделей, а также для отслеживания зависимостей и результатов в конвейерах машинного обучения.
- Хранить полные массивы данных непосредственно в артефактах или использовать ссылки на артефакты для указания на данные в других системах наподобие S3, GCP, или на локальной машине.
в) Data Version Control (DVC)
DVC — это open-source-платформа для проектов машинного обучения. DVC помогает дата-саентистам и разработчикам в контроле версий данных, управлении рабочим процессом и экспериментами. DVC позволяет выполнять следующие операции:
- Записывать версии данных и моделей в коммиты Git, параллельно с хранением их на машинах пользователей или в облачном хранилище.
- Переключаться между различным содержимым данных.
- Создавать метафайлы с описанием того, какие массивы данных и артефакты ML нужно отслеживать.
5. Знание предметной области
При датацентрическом подходе чрезвычайную ценность имеет знание предметной области. Специалисты в предметной области часто способны выявлять мелкие несоответствия, незаметные для инженеров ML, дата-саентистов или разметчиков. Труд специалистов в предметной области по-прежнему не используется в ML-системе. Производительность ML-систем можно улучшить, использовав дополнительные знания предметной области.
Преимущества датацентрического подхода
Переход к датацентрическим методикам имеет множество преимуществ, от повышения скорости и точности до более осознанного принятия решений. Датацентрическая инфраструктура обладает следующими преимуществами:
- Повышает точность; использование данных в качестве стратегического ресурса гарантирует более точные оценки, наблюдения и решения.
- Устраняет необходимость сложных преобразований данных.
- Уменьшает количество ошибок и несоответствий в данных.
- Предоставляет важную информацию о внутренних и внешних трендах, позволяющую принимать более оптимальные решения.
- Снижает расходы.
- Упрощает доступ к данным для руководства.
- Снижает избыточность данных.
- Повышает качество и надёжность данных.
Чему отдавать приоритет: количеству или качеству данных?
Прежде чем двигаться дальше, нам стоит подчеркнуть, что увеличение количества данных не означает автоматически повышение их качества. Разумеется, нейросеть невозможно обучить на малом количестве изображений, но упор нужно делать на качество, а не на количество.
Количество данных
Под этим понятием подразумевается объём доступных данных. Основная задача — собрать максимально возможное количество данных, а затем обучить нейросеть.
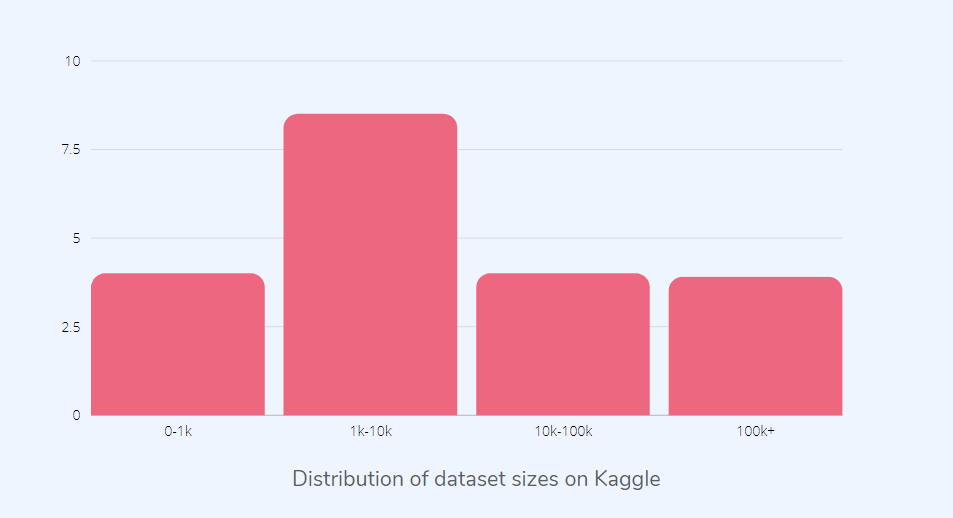
Как видно из рисунка выше, большинство массивов данных Kaggle не очень велико. При датацентрическом подходе размер массива данных не так важен, и многое можно сделать даже с небольшим качественным массивом данных.
Качество данных
Как понятно из названия, здесь важно качество данных. Не важно, есть ли у вас миллионы массивов данных; главное, чтобы они имели высокое качество и были правильно размечены.

Различные подходы к созданию ограничивающих прямоугольников
На рисунке выше показаны различные способы разметки данных; нет ничего плохого в разметке их по отдельности или вместе. Однако если дата-саентист 1 размечает каждый ананас отдельно, а дата-саентист 2 размечает их вместе, то данные будут несовместимыми, из-за чего алгоритм обучения запутается. Основная задача — обеспечение согласованности меток; если вы размечаете объекты по отдельности, сделайте так, чтобы все объекты размечались одинаково.
Согласованность аннотирования данных критически важна, потому что любые несоответствия могут сбить модель с толку и сделать её оценку неточной. Поэтому необходимо тщательно составлять инструкции по аннотированию, чтобы инженеры ML и дата-саентисты размечали данные согласованно. Согласно исследованию, приблизительно 3,4% сэмплов в часто используемых массивах данных имеют ошибочные метки, и ошибок больше в больших моделях.

Важность согласованности в малых массивах данных | Источник
На приведённом выше рисунке Эндрю Ын объясняет важность согласованности малых массивов данных. График иллюстрирует соотношение между напряжением и скоростью дрона. Если ваши массивы данных малы, однако их метки согласованы, то вы сможете с большей уверенностью подобрать кривую и получить более высокую точность.
Из-за низкокачественных данных изъяны и неточности могут без каких-либо последствий постоянно оставаться необнаруженными. Точность моделей зависит от качества данных; если вы хотите принимать хорошие решения, то вам нужна точная информация. Данные с плохими атрибутами подвержены риску наличия ошибок и аномалий, которые при использовании предсказательной аналитики и техник моделирования могут стоить вам очень дорого.
Сколько данных достаточно?
Количество имеющихся данных критически важно; для решения задачи необходимо иметь достаточный объём данных. Глубокие нейросети — это компьютеры с малым смещением и высокой дисперсией, и мы полагаем, что решением проблемы дисперсии является увеличение объёма данных. Но какого количества данных достаточно? Ответить на этот вопрос не так уж просто. Yolov5 даёт следующие рекомендации:
- Минимум 1,5 тысяч изображений на каждый класс.
- Минимум 10 тысяч экземпляров (размеченных объектов) на класс в сумме.
Рекомендации по датацентрическому подходу
При внедрении датацентрического подхода не забывайте о следующих аспектах:
- Обеспечивайте постоянно высокое качество данных на протяжении всего жизненного цикла ML-проекта.
- Поддерживайте согласованность меток.
- Используйте данные из продакшена, чтобы вовремя получать обратную связь.
- Применяйте анализ ошибок, чтобы сосредоточиться на подмножестве данных.
- Избавляйтесь от шумных сэмплов; как говорилось выше, «больше» не всегда означает «лучше».
Где искать качественные массивы данных?
Получение высококачественных массивов данных — важная задача. Такие массивы данных можно получить бесплатно в следующих местах:
Kaggle

Первый источник хорошо известен в сообществе дата-саентистов. В Kaggle вы найдёте весь код и данные для работы в data science. У него есть более 50 тысяч публичных массивов данных и 400 тысяч публичных ноутбуков, что позволяет быстро выполнить любой анализ.
Datahub.io

Datahub — это платформа массивов данных, в основном для сфер бизнеса и финансов. На DataHub доступно множество массивов данных, например, списки государств, населения и географических границ, и новые массивы продолжают разрабатываться.
Graviti Open Datasets

Graviti — это новая платформа данных, предоставляющая высококачественные массивы данных в основном для компьютерного зрения. Разработчики и организации могут получать удобный доступ к большим объёмам открытых данных, легко делиться и управлять ими.
Заключение
В этой статье мы узнали, как датацентрический подход отличается от моделецентрического, и как сделать процесс использования машинного обучения более датацентрическим. Мы не обязаны ограничивать развитие одним направлением, и код, и данные играют важную роль в разработке ИИ. Нет никаких жёстких и простых правил выбора между моделецентрическими и датацентрическими методиками, однако надёжность массива данных не стоит игнорировать.
Качество данных нужно поддерживать и совершенствовать на каждом этапе разработки ИИ, и каждый этап по определению требует различных фреймворков и инструментов. Если вам хочется изучить эту тему глубже, можете прочитать статьи по приведённым ниже ссылкам.
Ссылки и рекомендуемое чтение
- Pervasive Label Errors in Test Sets Destabilize Machine Learning Benchmarks
- Data-centric Machine Learning: Making customized ML solutions production-ready
- The Significance of Data-centric AI
- Tips for Best Training Results
- Data-centric AI: Real World Approaches
- разметка данных
- data labeling
- computer vision
- машинное обучение
- data annotation
- software
- dataset
- Training Data
- инструменты для разметки
- разметка датасета
Датацентричный мир
Мы живем в мире, где «умные» системы, устройства и алгоритмы ставят данные во главу угла при создании ценности для бизнеса, исследований, социума и отдельных лиц.
Мы видим, что этот мир позволяет нам делать все что угодно проще и быстрее. Мы зависим от больших быстро меняющихся наборов данных, которые в корне преобразили нашу жизнь и способы ведения бизнеса. Например, когда вы используете смартфон для навигации, вы получаете доступ к большому пулу данных, которые уже были обработаны и превращены в соответствующую информацию карты, к которой ваше устройство добавило ваше местоположение.
Точно так же данные способны обеспечить нас доступной и непрерывной электроэнергией, беспилотными автомобилями, медицинским обслуживанием нового качества, удобным общественным транспортом, производством и распространением недорогих товаров. Каждый из этих примеров реален, ведь датацентричные компании используют большие наборы данных, которые являются частью всемирного пула информации. Компании стремятся получить данные в нужном месте в нужное время, чтобы извлечь из них пользу. Они регулярно принимают решения, основанные на данных, инвестируют в данные, чтобы увеличить их доступность и использовать с наилучшим результатом. Если такой подход вам близок, то ваш бизнес датацентричен.
Цель цифровой трансформации – работа с данными
Ваша компания, скорее всего, уже столкнулась со сложностями в процессе превращения в организацию, ориентированную на данные. Например, создание ИТ-инфраструктуры проходит по новым сценариям. Исторически сложилось так, что ИТ могли обеспечить рост бизнеса, добавив серверов, виртуальных машин и инфраструктуры для обслуживания рабочих нагрузок в локальном центре обработки данных. Но теперь ИТ нацелены на охват внешних ресурсов для сбора, обработки и обмена данными, где бы такие ресурсы ни находились. Хотя ИТ-компании используют публичное облако, они не переносят туда системы и рабочие нагрузки целиком и одномоментно. Обычно их инженеры работают в гибридной среде, размещая системы и данные там, где это наиболее целесообразно с точки зрения технических и бизнес-потребностей. Когда компании оценивают свои дата-центры, которые естественным образом выросли вокруг их потребностей, они часто обнаруживают, что их ЦОД им вообще не принадлежит, а на приложения, платформы и инфраструктуру, которыми компании раньше владели локально, теперь можно выборочно подписываться «как на услугу». Выбирая между инфраструктурой как услугой (IaaS), платформой как услугой (PaaS) или ПО как услугой (SaaS), организация может определить, на каком уровне она хочет потреблять ИТ-ценность как услугу и располагать собственные ресурсы на верхнем уровне по необходимости.
Такое расширение существующих локальных сред, включающее в себя публичное облачное пространство, – логичное следствие вездесущности и центричности данных. В конце концов, нет никакой причины держать дополнительные вычислительные ресурсы без данных для обеспечения вычислительной мощности; нет никакого смысла запускать новые рабочие потоки в облаке или локально без данных для ввода и вывода. И уже недостаточно подключить вычислительные системы и СХД в соседних стойках к Fibre Channel или 10-гигабитной сети и ожидать, что это сделает данные доступными при необходимости. Реальная задача заключается в создании единой по всем параметрам платформы хранения данных, которая охватывает как локальные, так и облачные наборы информации.
Такая платформа устраняет изоляцию данных и позволяет гибридным приложениям следующего поколения беспрепятственно работать в облачных средах. Этот подход обеспечивает и мобильность приложений, позволяя легко переносить корпоративные приложения в публичную облачную среду и запускать web-scale приложения локально, а также последовательно разрабатывать приложения для обеих сред.
Эволюция аналитики
Еще одна область, где данные стимулировали трансформацию бизнеса, – это аналитика. Раньше она была изолированным проектом: отдельное ПО работало как пакетное приложение с собственным стеком вычислений и хранения. Теперь это повсеместный, непрерывный процесс. Растущий темп инноваций расширил добавил возможность сбора и обработки гораздо больших объемов данных, включая неструктурированную и внеплановую информацию. В итоге это позволило организациям получать ответы на вопросы, которые до появления повсеместной аналитики с преобразованием данных невозможно было даже задать.
Традиционный подход состоял в том, чтобы хранить бизнес-данные и периодически анализировать их в пакетных процессах. Этот подход был адекватен для анализа рынка или определения макротренда. Сегодня для обеспечения постоянных процессов принятия решений необходимы скорость и интеллектуальные расчеты. МО и ИИ стали новой нормой предварительной обработки для последующей автоматизации анализа данных.
Переход ИТ к унифицированному гибридному облаку, появление непрерывной аналитики – это наглядные примеры современного опыта хранения данных.
Что такое современный опыт хранения данных?
Согласно нашему видению, современный опыт хранения данных – это предоставление хранения данных как услуги, которая позволит клиентам извлекать максимальную ценность из данных с устранением сложностей и снижением затрат. Современный опыт хранения данных – это просто, без ограничений и навсегда.
Просто. Функциональные возможности использования, API, общие инструменты управления и действенная аналитика.
Без ограничений. Данные передаются по любому протоколу, на всех уровнях и между различными облаками, находясь при этом в единой среде.
Навсегда. Клиенты покупают только то, что им необходимо и когда им это необходимо, и всегда имеют возможность модернизировать систему до последней версии безболезненно и без каких-либо трудностей.
Некоторые организации уже используют такие продукты для консолидации дата-центров, построения мультиоблачной архитектуры, предоставления услуг высокой доступности и создания аналитического ядра, на котором будет базироваться их компания.
По мере того, как ИТ-директора стремятся повысить гибкость и эффективность корпоративной ИТ-инфраструктуры, они все чаще переходят на сервисную модель. Согласно исследованию IDC, 58% ИТ-организаций предпочитают такую модель в противовес капитальным расходам и лизингу. Кроме того, в следующие три года почти 60% облачной ИТ-инфраструктуры будет работать по сервисной модели по сравнению с 50% сегодня.
Современная ИТ-среда
Наиболее продвинутые предприятия знают о потенциале своих данных и используют их для лучшего понимания своих клиентов и в качестве конкурентного преимущества. Они также знают, что не все данные равноценны. Чтобы создать самые современные ИТ-среды и получить максимальную отдачу, необходимо признать, что разным типам данных необходимы различные доступ, хранение и управление.
Современные ИТ-среды – плод реализации стратегии данных, основанной на гибких моделях потребления в локальных, хостинговых и публичных облачных средах, которые позволяют согласовать рабочие нагрузки приложений с наиболее эффективной инфраструктурой. Самое главное, современная ИT-среда гармонично сочетается с общим интерфейсом управления, архитектурой и проактивными/прогнозирующими службами поддержки.
Преимущества современной ИТ-среды
При правильной реализации современная ИТ-среда даст организации несколько преимуществ. К ним относится высокоскоростная обработка больших объемов данных, которая делает их доступными для приложений, пользователей и машин, где бы те ни находились. В результате повышается эффективность и гибкость процессов.
Бизнес получит выгоду от масштабируемых, гибких услуг для приложений и разработчиков, предоставляемых по требованию, с автоматизацией на основе политик, которая эффективно поддерживает услуги, сводя к минимуму и даже устраняя необходимость повторного вмешательства.
Кроме того, современная ИT-среда позволяет сосуществовать и взаимодействовать с локальными, хостинговыми, сервисными и публичными облачными ресурсами данных, давая приложениям возможность использовать наиболее подходящее сочетание и мобильность ресурсов для удовлетворения конкретных потребностей бизнеса.
Наконец, современная ИТ-среда совершенствуется и модернизируется, постоянно работая со скоростью, которая требуется приложениям и пользователям, сводя к минимуму проблемы устаревания технологий. Это означает, что предприятия больше не должны волноваться о каких бы то ни было простоях, запланированных или незапланированных. Время для плановых простоев, когда сотрудники лишаются доступа к данным, ушло в прошлое.
Взгляд в будущее
Ведущие организации сегодня продолжат движение в сторону единой ИТ-среды с полной гибкостью перемещения данных между публичными и частными облаками. Такой подход помогает организациям заменить устаревшие системы хранения на быстрые и гибкие ресурсы, подходящие для современных условий эксплуатации. Именно те организации, которые предусмотрительно применят этот подход сейчас, смогут конкурировать на самом высоком уровне в следующем десятилетии.
Датацентричный подход что это
При проектировании, разработке и развитии программного обеспечения и информационных систем зачастую полученные программные продукты являются обособленными относительно друг друга и систем заказчика или потребителя ввиду отсутствия первоначальных требований в возможности дальнейшей их интеграции с другими сервисами и программами (как существующими, так и будущими). Это приводит к повышению требований к объёмам вычислительных мощностей или/и к дополнительным накладным расходам на развитие информационной инфраструктуры. Это обусловлено либо необходимостью в реализации дополнительного промежуточного программного слоя для оказания информационной совместимости между данными разных видов и форматов, либо необходимостью производить регулярные кардинальные изменения многих уже имеющихся программных компонентов, затраты на модернизацию которых с каждым витком будут увеличиваться вместе с размерами самой системы. Однако с помощью датацентричного подхода эту проблему можно решить. В этой статье описаны преимущества и недостатки датацентричного подхода проектирования архитектуры информационных систем, а также описаны преимущества внедрения датацентризма поверх распределённых архитектур информационных систем, а также какие характеристики получит система, построенная с применением принципов обоих архитектурных подходов.

датацентризм
распределённые информационные системы
архитектуры информационных систем
1. Идигова Л.М., Абубакаров А.Х. Datascience как новый тренд. Исследование методов работы с большим объемом данных в организации // Влияние новой геополитической реальности на государственное управление и развитие Российской Федерации: материалы II Всероссийской научно-практической конференции (Грозный, 20–21 сентября 2019 г.) / Под ред. З.А. Саидова. Грозный: Чеченский государственный университет, 2019. С. 275–280.
2. Big Data Explained [Электронный ресурс]. URL: https://www.mongodb.com/big-data-explained (дата обращения: 01.05.2022).
3. Величко Н.А., Митрейкин И.П. Технология Big Data. Анализ рынка Big Data // Синергия Наук. 2018. № 30. С. 937–943.
4. The Data-Centric Revolution [Электронный ресурс]. URL: https://tdan.com/the-data-centric-revolution/18780 (дата обращения: 01.05.2022).
5. Обзор современных распределенных систем [Электронный ресурс]. URL: https://scienceforum.ru/2020/article/2018023457 (дата обращения: 01.05.2022).
6. Страх и ненависть в распределённых системах [Электронный ресурс]. URL: https://habr.com/ru/post/322876/ (дата обращения: 01.05.2022).
7. Шатилов А.А. Разработка программной архитектуры мобильного приложения «Социальный будильник» // Всероссийская научная конференция молодых исследователей с международным участием «Инновационное развитие техники и технологий в промышленности (ИНТЕКС-2021)». М.: ФГБОУ ВО «РГУ им. А.Н. Косыгина», 2021. С. 111–115.
8. The Data-Centric Manifesto [Электронный ресурс]. URL: http://datacentricmanifesto.org/principles (дата обращения: 30.05.2022).
9. Data-centric Architecture – A Different Way of Thinking [Электронный ресурс]. URL: https://www.vistaprojects.com/blog/data-centric-architecture (дата обращения: 01.05.2022).
10. Три шага к датацентричной архитектуре [Электронный ресурс]. URL: https://www.osp.ru/os/2019/04/13055224 (дата обращения: 01.05.2022).
11. Лекция 12: Компонентные технологии и разработка распределенного ПО [Электронный ресурс]. URL: https://intuit.ru/studies/higher_education/3406/courses/64/lecture/1888 (дата обращения: 01.05.2022).
12. Построение распределенных систем обработки информации [Электронный ресурс]. URL: https://spravochnaya.com/7688_postroenie-raspredelennyh-sistem-obrabotki-informacii.html (дата обращения: 01.05.2022).
13. VK Cloud Solutions. Что такое big data: зачем нужны большие данные, как их собирают и обрабатывают. [Электронный ресурс]. URL: https://mcs.mail.ru/blog/big-data-vse-govoryat-no-malo-kto-shchupal (дата обращения: 31.05.2022).
14. Oracle Cloud Infrastructure. Что такое большие данные? [Электронный ресурс]. URL: (дата обращения: 31.05.2022).
Развитие ИТ (информационных технологий), а также растущая популярность так называемой «науки о данных» (data science) связана с эффективностью деятельности организаций, которая только возрастает при грамотных сборе, обработке и применении собранного большого количества данных [1] в связи с современными требованиями бизнеса в оперативной реакции на большие потоки разнообразной информации. Большое количество собранных данных стало носить название «большие данные» (big data) [2] и иметь отдельную ценность в зависимости от деятельности организации, собирающей, обрабатывающей и применяющей на практике эти данные [3]. На фоне этого устоявшиеся методы разработки информационных систем становятся неэффективны в рамках развития информационных систем и приводят к громоздким программным решениям.
Цель исследования – провести обзор, характеристику и сравнение традиционного (приложение-ориентированного) и датацентричного подхода при проектировании информационных систем, а также рассмотреть применение датацентризма в рамках распределённых систем и в сфере больших данных.
Материалы и методы исследования
Обзор и анализ открытых источников (в том числе на иностранном языке), сравнение представленных подходов проектирования информационных систем.
Результаты исследования и их обсуждение
На фоне этого одни и те же данные могут иметь разный вид и формат, быть продублированы в разных программных приложениях, выполняющих разные задачи по их обработке. Это приводит к сильному разделению информации по её разным характеристикам: по характеру выполняемых действий над ними, невзирая на их содержимое, по форме и месту их записи, по типу исходников. Это попутно усложняет ИТ-инфраструктуру организаций, повышая издержки на её обслуживание.
В итоге это приводит к пониженной эффективности систем хранения данных, систем и приложений, а также повышенной стоимости разработки и поддержки программных и аппаратных средств сбора и обработки информации из-за возникновения копий одних и тех же данных в разных формах и/или форматах, направленных на использование в различных программных системах.
Возникает это в первую очередь из-за «традиционного» подхода к проектированию информационных систем, где в центре внимания находится само программное приложение – «приложение центризм» (Application Centric) [4]. Другими словами, проектирование ведётся обособленно от уже имеющихся данных и других информационных систем, начиная с программного кода и заканчивая формированием формата и формы данных, а также организация их хранения для конкретной программы.
Также для работы программ в условиях высокой нагрузки применяются методы проектирования распределённых информационных систем [5], которые способствуют более простому и менее затратному её дальнейшему масштабированию в рамках выполняемых ими задач [6]. Но, когда возникает необходимость в создании дополнительной подсистемы или выполнении специфической работы над собранными данными, полученными исходной информационной системой, возникает необходимость в создании отдельных методов подготовки и переноса данных из существующей системы в новую (другими словами – организовать слой для конвертации данных из системы А в систему Б) посредством отдельного прикладного программного обеспечения, созданного исключительно для этих целей (рис. 1), что требует выделения отдельных ресурсов.
Помимо наличия издержек на расширение функционала за счёт промежуточного прикладного программного обеспечения может возникнуть ситуация, в которой может происходить снижение производительности исходной информационной системы. Это может происходить, если полученные в процессе конвертации данные физически будут находиться и управляться в системе управления базами данных исходной системы, создавая две копии одних и тех же данных, рассчитанные на обработку в разных системах – связано это в первую очередь с разделением аппаратных ресурсов базы данных на обслуживание данных нескольких систем.
Эту проблему можно решить посредством «стандартизации» данных, то есть приведения аккумулированной информации в единый для организации избыточный формат (или приспособленной для масштабирования схемы данных). Благодаря этому компоненты разных информационных систем смогут беспрепятственно оперировать одними и теми же наборами данных, сокращая расходы вычислительных ресурсов за счёт исключения и сокращения процессов копирования, конвертации и переноса (в случае разных хранилищ данных для разных систем) информации для её последующей передачи компонентам систем, а также потенциально даёт возможность сократить издержки, связанные с необходимостью дальнейшего расширения систем хранения данных.
Датацентризм – это архитектурный подход к построению информационных систем, где центральным и главным звеном являются данные, без которых невозможно обеспечить результативность программных систем и отдельных приложений [7]. На уровне архитектуры датацентризм выражается в наличии центральной системы хранения и управления данных в качестве главного компонента информационной системы.
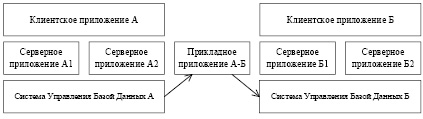
Рис. 1. Появление второстепенной информационной системы на базе собранных данных исходной системы
Сравнение подходов [8]
Высокая стоимость изменений
Внедрение датацентричного подхода начинается с наведения порядка в данных

— Думаю, что радикальных реформ ждать не стоит. Еще несколько лет назад регулятор анонсировал постепенный переход банков от формацентричного подхода к датацентричному. И сейчас мы наблюдаем плавное, без резких скачков, движение в сторону сбора информации от кредитных организаций на основе единой модели данных.
В отличие от истории с XBRL в некредитных финансовых организациях (НФО), когда внедрялось все и сразу, в банках разработка единой референсной модели ведется по предметным областям. Первый важный шаг в этом направлении — таблица исходных данных (ТИД) «Ссуды».
Финальная версия ТИД ожидается в ноябре 2023 года, но совместная работа над ней Банка России и кредитных организаций ведется уже несколько месяцев. Поэтому информация поступает, и уже очевидно, что применение ТИД не приведет к технологической революции. В этой области перемены тоже будут происходить постепенно. Тем более что решение об использовании ТИД каждый банк принимает добровольно.

Валерий Чаусов, генеральный директор «Интерсофт Лаб». Фото: «Интерсофт Лаб»
— Так к каким технологическим новшествам готовиться банкам в ближайшее время?
— Давайте оттолкнемся от целей. Датацентичный подход — это когда регулятор получает от банков не данные по формам отчетности, а поток первичных данных, согласно референсной модели. ТИД в самом простом понимании — это описание части модели, которая консолидирует атрибутный состав для определенной области деятельности банка.
Предполагается, что на данном этапе вместе с ТИД банки будут получать описание проверок качества данных и алгоритмов расчета показателей для форм отчетности, которые опираются на ТИД. Такой набор информации по своей сути соответствует техническому заданию на автоматизацию пакета отчетных форм. Причем в нем уже проведена оптимизационная работа: исключено дублирование расчетов и показателей, а состав данных ТИД покрывает подготовку всех заданных форм.
Таким образом, внедрение датацентричного подхода начинается с наведения порядка в данных. Проще говоря, после получения ТИД банк должен провести инвентаризацию данных, чтобы понять, какие из них и откуда (из каких источников) надо получать, чтобы соответствовать ей. И эта задача будет возникать при любом изменении регуляторных требований или модернизации учетных систем банка. Поэтому целесообразно наладить мониторинг данных и контроль их соответствия сначала ТИД, а в перспективе — полной референсной модели данных.
Для этого необходимо специализированное ПО. Можно использовать автономные системы управления данными, так называемые Data Governance (сокращенно — DG). Они служат исключительно для описания данных. Такой функционал также может быть частью платформы для создания хранилища данных и подготовки отчетности на его основе. На мой взгляд, второй подход в большей степени оправдан.
— Почему?
— Как минимум он исключает дублирование функций описания данных, сначала в системе управления данными, а потом в системе подготовки отчетности. Хотя DG как рабочее место директора по данным, безусловно, имеет свою ценность. Но если смотреть на задачу мониторинга и контроля данных в контексте подготовки регуляторной отчетности, то хранилище данных гораздо больше готово к ее решению.
Во-первых, оно опирается на модель данных. Достаточно настроить эту модель, согласно ТИД, чтобы автоматически контролировать достаточность данных, которые собираются в хранилище в регуляторных целях. Благодаря системе управления метаданными все загруженные данные могут быть описаны в тех терминах, которыми оперируют методические рекомендации регулятора и ТИД.
Во-вторых, в хранилище встроены проверки данных. Они выполняются при загрузке данных и после нее. Если обеспечить соответствие процедур в хранилище требованиям к проверкам для ТИД, можно установить автоматический контроль качества данных.
Наконец, хранилище оснащено инструментами обогащения данных. Они помогают автоматически сгенерировать в хранилище часть недостающих данных, если удается отыскать алгоритмы их создания. Это, конечно, не панацея, но в отдельных случаях может оказаться очень полезным.
Вообще, в зрелых платформах хранилищ данных накоплено много ценного, в том числе для решения регуляторных задач. Например, в хранилище «Контур» фиксируется история изменения всех данных и правил их обработки во времени и сохраняется «аудиторский след». Это тоже важное для регуляторных целей свойство хранилища данных.
— А почему не поручить мониторинг и контроль данных АБС?
— Отчасти эту задачу можно решать и в основной банковской системе. Однако вряд ли найдутся кредитные организации, в которых все данные, необходимые для регуляторных целей, хранятся в одной только АБС. Практически всегда в банках больше одного источника данных, а хранилище, как известно, — инструмент для консолидации.
Конечно, в учетные модули встроены контроли при вводе данных, но они решают очень узкую задачу. Этих проверок хватает, чтобы заполнить договор или как-то иначе оформить услугу, но для корректной подготовки всей банковской отчетности их недостаточно. Самый очевидный пример: в АБС не выполняется сверка данных бухгалтерского и оперативного учета.
Теоретически, можно расширить состав проверок в АБС, но это, скорее всего, негативно отразится на ее производительности и увеличит время обслуживания клиентов. Одним словом, каждая IT-система должна решать свои задачи: АБС обрабатывать — транзакции и выполнять несложные запросы, а хранилище — готовить качественные данные для отчетности.
— Почему же тогда хранилища данных до сих пор не стали главным инструментом для подготовки обязательной отчетности?
— Первая причина — целесообразность. Хранилище — идеальная платформа для подготовки отчетов, которые требуют консолидации данных из разных учетных систем, хранения истории их изменения и ресурсоемких вычислений. Но нет особого смысла переводить в хранилище выпуск оперативных отчетов по данным главной книги. Это оправдано, только если АБС банка не поддерживает централизованную работу.
Вторая причина — использование банками иностранных платформ для хранилищ данных. Атрибутный состав западных моделей не позволял применять их для регуляторных целей, поэтому в основном из таких хранилищ готовили внутреннюю отчетность.
Третья, и главная, причина — наследие прошлого. В каждом банке годами под влиянием разных факторов складывалось уникальное распределение форм между АБС, электронными таблицами и хранилищем данных. Эффективность у таких конфигураций разная, но процессы налажены. Смена привычной технологии — это всегда болезненно, а построение хранилища данных и перенос в него подготовки сложных форм — еще и трудоемко и затратно. Поэтому решения об открытии проектов автоматизации регуляторной отчетности на базе хранилищ данных принимаются долго и трудно.
И все же когда-то критическая масса достигается. Возможно, сейчас тот самый переломный момент, когда параллельно с переводом наработанных банками решений на отечественные программные компоненты стоит изменить сложившийся уклад в подготовке регуляторной отчетности и сразу выбрать архитектуру на базе хранилища данных, чтобы поддержать датацентричный подход. Начать можно с поддержки первой ТИД «Ссуды» и автоматизации пакета форм на ее основе.
В целом, убежден, что за хранилищами — будущее автоматизированного сбора данных для надзорных целей.
— Насколько хранилище данных «Контур» готово к автоматизации отчетности на базе ТИД?
— Совершенно готово. Дело в том, что предложенный Банком России подход с использованием ТИД полностью соответствует идеологии автоматизации отчетности на платформе «Контур». Проектный опыт привел нас к необходимости объединять детальные данные по предметным областям, чтобы выпускать на их основе «родственную» отчетность.
Тиражная витрина данных «Кредитный портфель» для хранилища «Контур» — готовый рабочий прототип ТИД «Ссуды». На ее основе уже сегодня в банках готовятся формы 0409115, 0409303, 0409310, 0409316 и выгрузка данных для Бюро кредитных историй. Поэтому для нас это понятная тема и уже реализованный и проверенный в деле функционал.
Мы ждем только финальных требований к ТИД, чтобы гарантировать полное соответствие им атрибутного состава нашей витрины, проверок качества данных и расчетных алгоритмов. Добавлю, что финансовая модель хранилища данных «Контур» полностью соответствует мартовским методическим рекомендациям Банка России 5-МР, поэтому серьезных изменений нашего решения в ноябре мы не предполагаем.