Плавное введение в Natural Language Processing (NLP)
Люди общаются с помощью каких-либо форм языка и пользуются либо текстом, либо речью. Сейчас для взаимодействия компьютеров с людьми, компьютерам необходимо понимать естественный язык, на котором говорят люди. Natural language processing занимается как раз тем, чтобы научить компьютеры понимать, обрабатывать и пользоваться естественными языками.
В этой статье мы рассмотрим некоторые частые методики, применяющиеся в задачах NLP. И создадим простую модель сентимент-анализа на примере обзоров на фильмы, чтобы предсказать положительную или отрицательную оценку.
Что такое Natural Language Processing (NLP)?
NLP — одно из направлений искуственного интеллекта, которое работает с анализом, пониманем и генерацией живых языков, для того, чтобы взаимодействовать с компьютерами и устно, и письменно, используя естественные языки вместо компьютерных.
Применение NLP
- Machine translation (Google Translate)
- Natural language generation
- Поисковые системы
- Спам-фильтры
- Sentiment Analysis
- Чат-боты
Очистка данных (Data Cleaning):
При Data Cleaning мы удаляем из исходных данных особые знаки, символы, пунктуацию, тэги html <> и т.п., которые не содержат никакой полезной для модели информации и только добавляют шум в данные.
Что удалять из исходных данных, а что нет зависит от постановки задачи. Например, если вы работаете с текстом из сферы экономики или бизнеса, знаки типа $ или другие символы валют могут содержать скрытую информацию, которую вы не хотите потерять. Но в большинстве случаев, мы их удаляем.
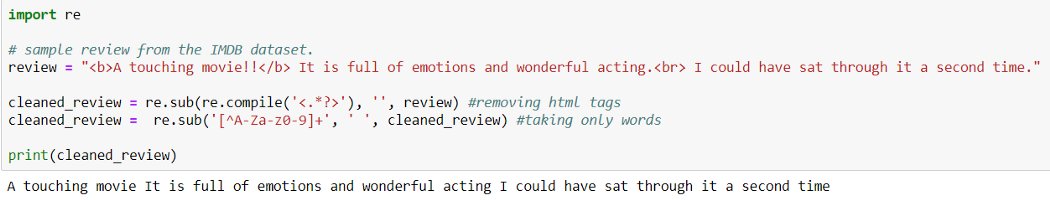
Код на Python: Data cleaning
Предварительная обработка данных (Preprocessing of Data)
Preprocessing of Data это этап Data Mining, который включает в себя трансформацию исходных данных в доступный для понимания формат.
Изменение регистра:
Одна из простейших форм предварительной обработки текста — перевод всех символов текста в нижний регистр.
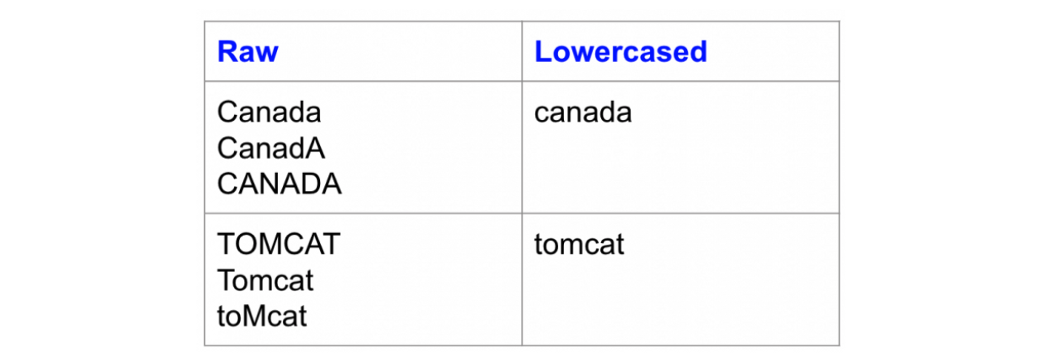
Источник изображения

Код на Python: перевод в нижний регистр
Токенизация:
Токенизация — процесс разбиения текстового документа на отдельные слова, которые называются токенами.
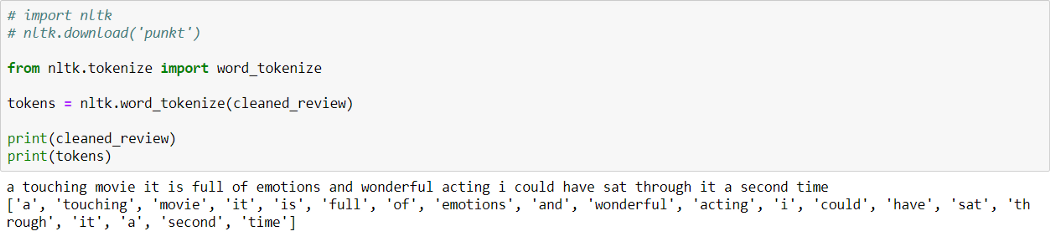
Код на Python: Токенизация
Как можно видеть выше, предложение разбито на слова (токены).
Natural language toolkit (библиотека NLTK) — популярный открытый пакет библиотек, используемых для разного рода задач NLP. В этой статье мы будем использовать библиотеку NLTK для всех этапов Text Preprocessing.
Вы можете скачать библиотеку NLTK с помощью pip:
!pip install nltk
Удаление стоп-слов:
Стоп-слова — это часто используемые слова, которые не вносят никакой дополнительной информации в текст. Слова типа «the», «is», «a» не несут никакой ценности и только добавляют шум в данные.
В билиотеке NLTK есть встроенный список стоп-слов, который можно использовать, чтобы удалить стоп-слова из текста. Однако это не универсальный список стоп-слов для любой задачи, мы также можем создать свой собствпнный набор стоп-слов в зависимости от сферы.
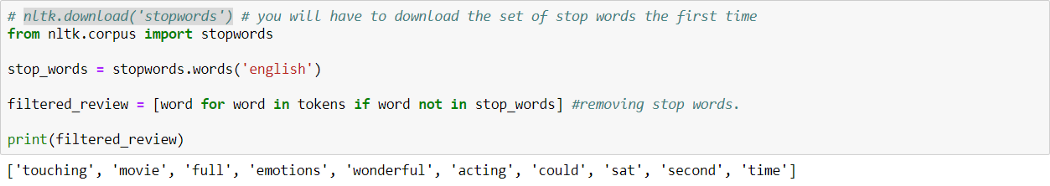
Код на Python: Удаление стоп-слов
В библиотеке NLTK есть заранее заданный список стоп-слов. Мы можем добавитьили удалить стоп-слова из этого списка или использовать его в зависимости от конкретной задачи.
Стеммизация:
Стеммизация — процесс приведения слова к его корню/основе.
Он приводит различные вариации слова (например, «help», «helping», «helped», «helpful») к его начальной форме (например, «help»), удаляет все придатки слов (приставка, суффикс, окончание) и оставляет только основу слова.
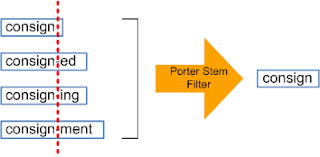
Источник изображения
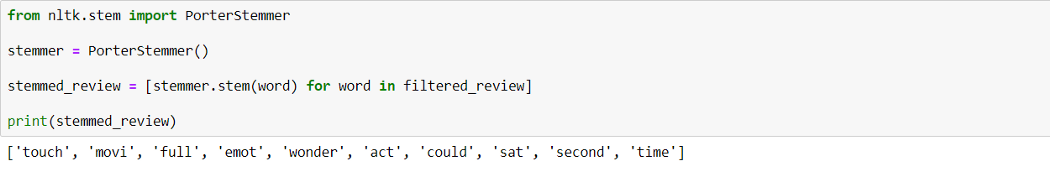
Код на Python: Стеммизация
Корень слова может быть существующим в языке словом, а может и не быть им. Например, «mov» корень слова «movie», «emot» корень слова «emotion».
Лемматизация:
Лемматизация похожа на стеммизацию в том, что она приводит слово к его начальной форме, но с одним отличием: в данном случае корень слова будет существующим в языке словом. Например, слово «caring» прекратится в «care», а не «car», как в стеммизаци.
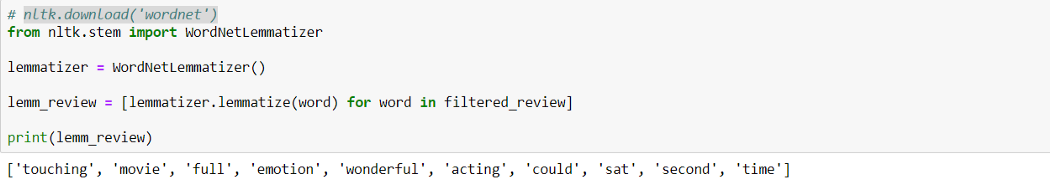
Код на Python: Лемматизация
WordNet — это база существующих в английском языке слов. Лемматизатор из NLTK WordNetLemmatizer() использует слова из WordNet.
N-граммы:
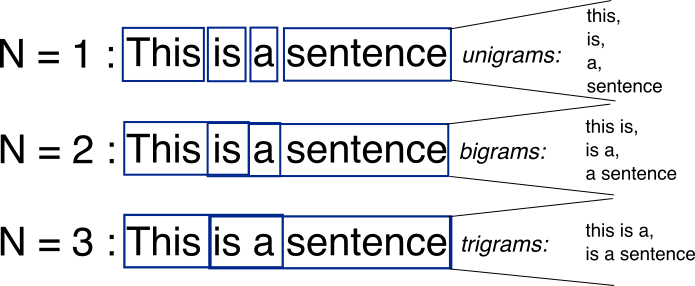
Источник изображения
N-граммы — это комбинации из нескольких слов, использующихся вместе, N-граммы, где N=1 называются униграммами (unigrams). Подобным же образом, биграммы (N=2), триграммы (N=3) и дальше можно продолдать аналогичным способом.
N-граммы могут использоваться, когда нам нужно сохранить какую-то последовательность данных, например, какое слово чаще следует за заданным словом. Униграммы не содержат никкой последовательности данных, так как каждое слово берется индивидуально.
Векторизация текстовых данных (Text Data Vectorization):
Процесс конвертации текста в числа называется векторизацией. Теперь после Text Preprocessing, нам нужно представить текст в числовом виде, то есть закодировать текстовые данные в виде чисел, которые в дальнейшем могут использоваться в алгоритмах.
«Мешок слов» (Bag of words (BOW)):
Это одна из самых простых методик векторизации текста. В логике BOW два предложения могут называться одинаковыми, если содержат один и тот же набор слов.
Рассмотрим два предложения:

Источник изображения
В задачах NLP, каждое текстовое предложение называется документом, а несколько таких документов называют корпусом текстов.
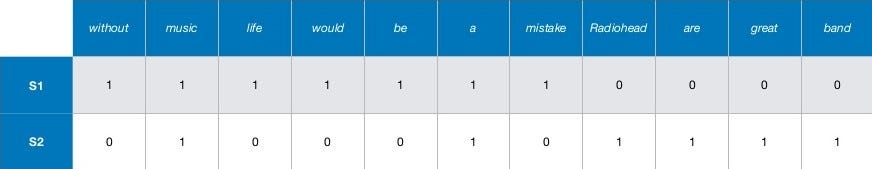
BOW создает словарь уникальных d слов в корпусе (собрание всех токенов в данных). Например, корпус на изображении выше состоит из всех слов предложений S1 и S2.
Теперь мы можем создать таблицу, где столбцы соответствуют входящим в корпус уникальным d словам, а строки предложениям (документам). Мы устанавливаем значение 1, если слово в предложении есть, и 0, если его там нет.
Источник изображения
Это позволит создать dxn матрицу, где d это общее число уникальных токенов в корпусе и n равно числу документов. В примере выше матрица будет иметь форму 11×2.
TF-IDF:

Источник изображения
Это расшифровывается как Term Frequency (TF)-Inverse Document Frequency (IDF).
Частота слова (Term Frequency):
Term Frequency высчитывает вероятность найти какое-то слово в документе. Ну, например, мы хотим узнать, какова вероятрность найти слово wi в документе dj.
Term Frequency (wi, dj) =
Количество раз, которое wi встречается в dj / Общее число слов в dj
Обратная частота документа (Inverse Document Frequency):
В логике IDF, если слово встречается во всех документах, оно не очень полезно. Так определяется, насколько уникально слово во всем корпусе.
IDF(wi, Dc) = log(N/ni)
Здесь Dc = Все документы в корпусе,
N = Общее число документов,
ni = документы, которые содержат слово (wi).
Если wi встречается в корпусе часто, значение IDF снижается.
Если wi используется не часто, то ni снижается и вследствие этого значение IDF возрастает.
TF(wi, dj) * IDF(wi, Dc)
TF-IDF — умножение значений TF и IDF. Больший вес получат слова, которые встречаются в документе чаще, чем во всем остальном корпусе.
Sentiment Analysis: Обзоры фильмов на IMDb
Источник изображения
Краткая информация
Набор данных содержит коллекцию из 50 000 рецензий на сайте IMDb, с равным количеством положительных и отрицательных рецензий. Задача — предсказать полярность (положительную или отрицательную) данных отзывов (тексты).
1. Загрузка и исследование данных
Набор данных IMDB можно скачать здесь.
Обзор набора данных:
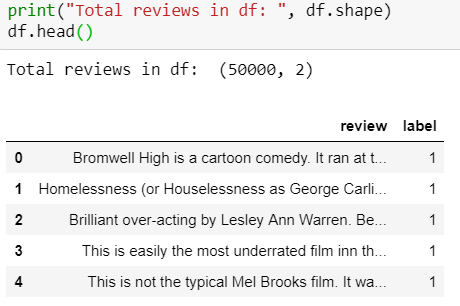
Положительные рецензии отмечены 1, а отрицательные 0.
Пример положительной рецензии:

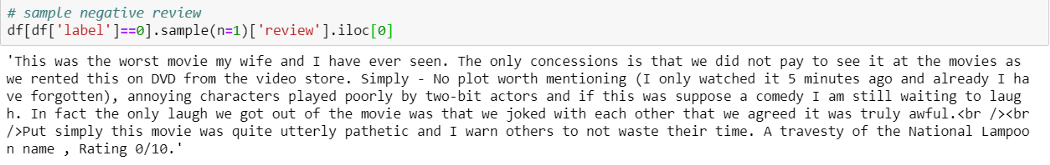
Пример отрицательной рецензии:
2. Data Preprocessing
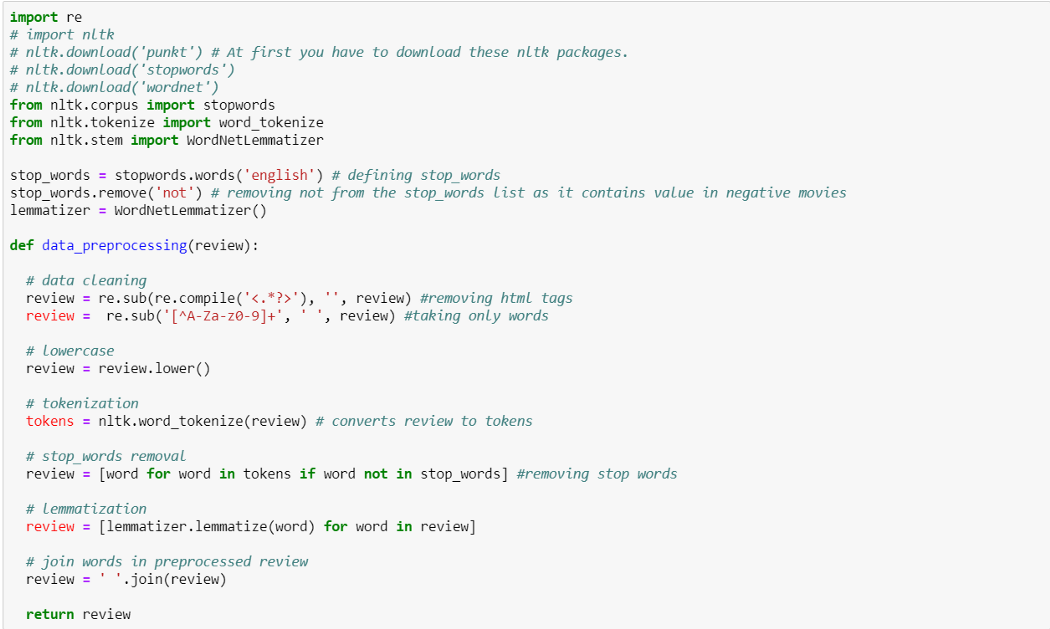
На этом этапе мы совершаем все шаги очистки и предварительной обработки данных тем методом, который был описан выше. Мы используем лемматизацию, а не стеммизацию, потому что в процессе тестирования результатов обоих случаев лемматизация дает лучшие результаты, чем стеммизация.
Использовать ли стеммизацию или лемматизацию или и то, и другое — зависит от поставленной задачи, так что нам стоит попробовать и решить, какой способ сработает лучше для данной задачи.
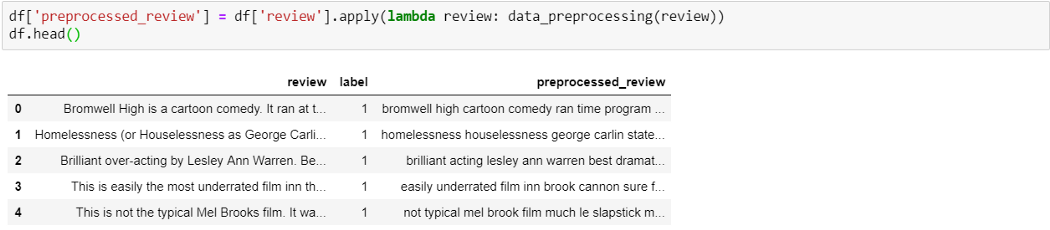
Добавляем новую колонку preprocessed_review в dataframe, применяя data_preprocessing() ко всем рецензиям.
3. Vectorizing Text (рецензии)
Разделяем набор данных на train и test (70–30):
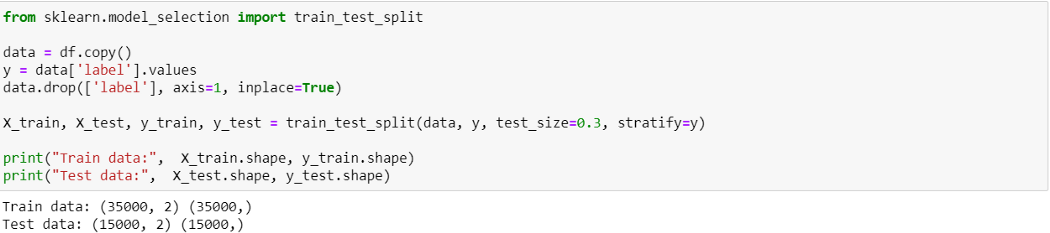
Используем train_test_split из sklearn, чтобы разделить данные на train и test. Здесь используем параметр stratify,чтобы иметь равную пропорцию классов в train и test.
BOW
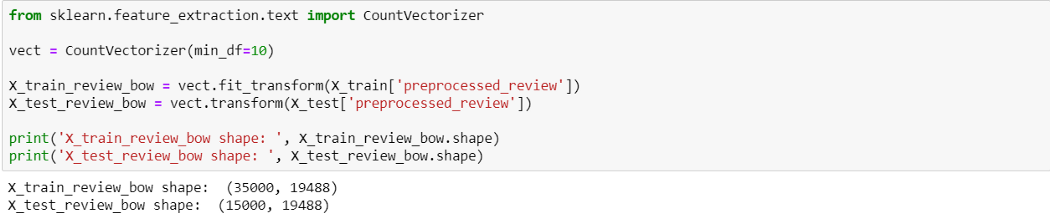
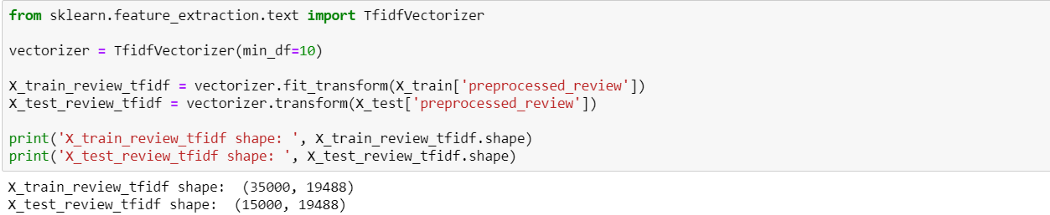
Здесь мы использовали min_df=10, так как нам нужны были только те слова, которые появляются как минимум 10 раз во всем корпусе.
TF-IDF
4. Создание классификаторов ML
Наивный байесовский классификатор (Naive Bayes) с рецензиями, закодированными BOW
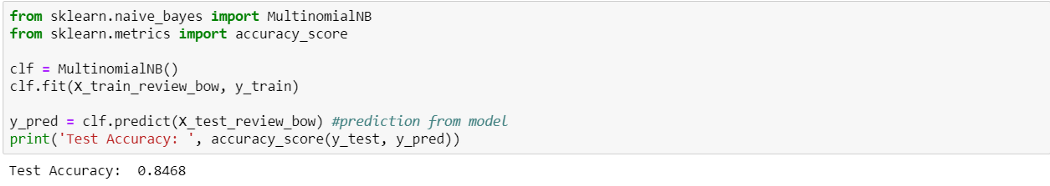
Naive Bayes c BOW выдает точность 84.6%. Попробуем с TF-IDF.
Наивный байесовский классификатор (Naive Bayes) с рецензиями, закодированными TF-IDF
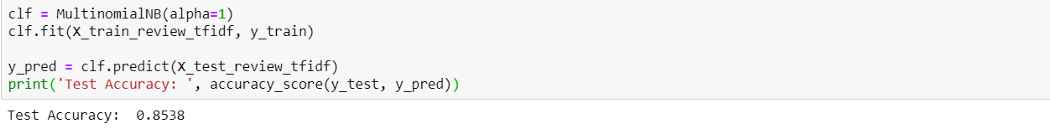
TF-IDF выдает результат немного лучше (85.3%), чем BOW. Теперь давайте попробуем TF-IDF с простой линеарной моделью, Logistic Regression.
Logistic Regression с рецензиями, закодированными TF-IDF
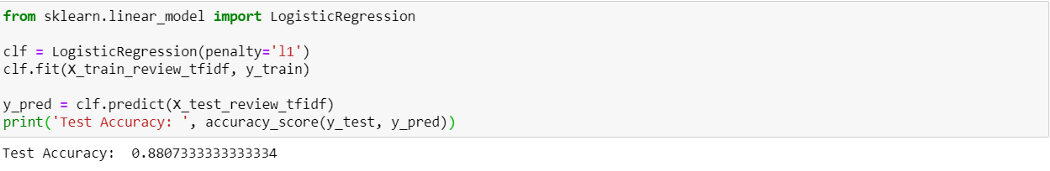
Logistic Regression с рецензиями, закодированными TF-IDF, выдает результат лучше, чем наивный байемовский — точность 88.0%.
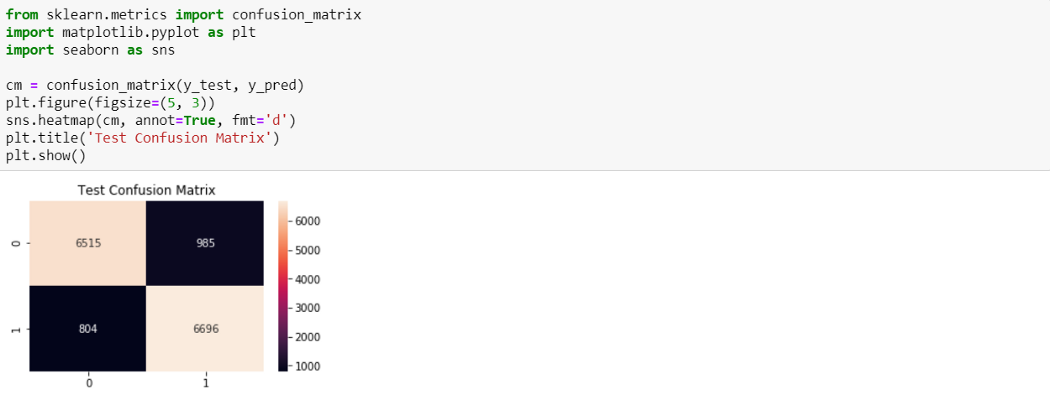
Построение матрицы неточностей даст нам информацию о том, сколько точек данных верны и сколько неверны, классифицированную с помощью модели.
Из 7500 отрицательных рецензий 6515 были верно классифицированы как отрицательные и 985 были неверно классифицированы как положительные. Из 7500 положительных рацензий 6696 были верно классифицированы как положительные, и 804 неверно классифицированы как отрицательные.
Итоги
Мы узнали основные задачи NLP и создали простые модели ML для сентимент-анализа рецензий на фильмы. В дальнейшем усоверешенствований можно добиться с помощью Word Embedding с моделями Deep Learning.
Благодарю за внимание! Полный код смотрите здесь.
Ссылки:
- Ultimate guide to deal with Text Data (using Python) – for Data Scientists and Engineers
- All you need to know about text preprocessing for NLP and Machine Learning
- Applied Course
Что такое обработка текстов на естественном языке (NLP)?
Определение обработки текстов на естественном языке (NLP)
Обработка текстов на естественном языке (NLP) — это одно из направлений использования искусственного интеллекта (ИИ), которое позволяет компьютерам понимать, порождать и обрабатывать тексты на естественных языках. Обработка текстов на естественном языке позволяет использовать для запросов к данным тексты или устные высказывания на естественном языке. Этот подход также называют «язык на входе». Многие потребители наверняка пользовались NLP, сами того не осознавая. Например, NLP — это основная технология, на которой основана работа виртуальных помощников, таких как Oracle Digital Assistant (ODA), Siri, Cortana или Alexa. Когда мы задаем вопросы таким помощникам, именно NLP позволяет им не только понимать запрос, но и отвечать на него на естественном языке. NLP применяется как к письменным текстам, так и к устной речи, и может работать со всеми естественными языками на земле. Среди других примеров инструментов, основанных на NLP, можно назвать веб-поиск, фильтрацию спама в электронной почте, автоматический перевод текстов и речи, аннотирование документов, анализ тональности текста и проверку грамматики и орфографии. Например, программа электронной почты может автоматически предлагать подходящий вариант ответа на основе содержания полученного письма. Такие программы используют NLP для чтения, анализа и подготовки ответа на письмо.
Есть еще несколько терминов, которые примерно синонимичны понятию NLP. Понимание естественного языка (NLU) и порождение естественного языка (NLG) означают использование компьютеров для понимания и порождения человеческих языков. NLG позволяет создавать словесные описания того, что произошло. Этот подход также называют «язык на выходе»: значимая информация обобщается и подается в виде текста благодаря использованию понятия «грамматика графики».
На практике понятие NLU используют в значении NLP. Понимание компьютером структуры и смысла человеческих языков позволяет разработчикам и пользователям взаимодействовать с компьютерами, используя естественные высказывания и предложения. Компьютерная лингвистика — это область науки, которая изучает использование вычислительных методов для работы с естественными языками, а NLP — это техническая дисциплина, занимающаяся созданием вычислительных артефактов, которые понимают, порождают или используют естественный язык.
Исследования в сфере NLP начались вскоре после создания компьютеров в 1950-х годах. NLP использует достижения лингвистики и искусственного интеллекта. Однако большинство достижений последних лет основаны на использовании машинного обучения, которое является одним из направлений ИИ и позволяет создавать обучающиеся и строящие обобщения на основе данных системы.Глубокое обучение — это разновидность машинного обучения, которая может осваивать довольно сложные модели на основе больших объемов данных. Это значит, что глубинное обучение идеально подходит для изучения сложностей естественного языка на основе наборов данных, полученных из Интернета.
Применение обработки текстов на естественном языке
Автоматизация рутинных задач. Чат-боты, опирающиеся на технологии NLP, могут выполнять большое количество рутинных операций, которыми сегодня занимаются люди, и таким образом дать сотрудникам возможность заниматься более сложными и интересными задачами. Например, чат-боты и цифровые ассистенты могут распознавать большое количество запросов пользователя, сопоставлять их с соответствующими записями в базе данных и формулировать подходящие ответы для пользователя.
Улучшенный поиск. В случае поиска по документам и часто задаваемым вопросам NLP может усовершенствовать поиск по ключевым словам за счет снятия неоднозначности слов на основе контекста (например, слово «носитель» имеет разное значение в медицине и промышленности), сопоставления синонимов (например, отбирать документы, содержащие слово «машина», если в поиске введено слово «автомобиль») и учета морфологических вариантов (что важно для запросов на языках, отличных от английского). Эффективный поиск по научным данным, основанный на технологиях NLP, может значительно упростить доступ к новейшим исследованиям для врачей, юристов и других специалистов.
Оптимизация поисковых систем. NLP — это прекрасный инструмент, который позволит вашей организации подняться выше в результатах онлайн-поиска, потому что он может проанализировать результаты и оптимизировать ваш контент. Поисковые системы используют NLP, чтобы ранжировать результаты поиска. Понимая, как эффективно использовать эти методы, можно легко добиться того, что ваша компания будет отображаться в результатах поиска выше конкурентов. Это значит, что у вашей компании будет больше просмотров.
Анализ и упорядочивание больших коллекций документов. Методы NLP, такие, как кластеризация документов и тематическое моделирование, упрощают задачу понимания разнообразных материалов в больших коллекциях документов, таких как отчеты компании, новые статьи или научные документы. Эти методы часто применяются для раскрытия информации по запросу.
Анализ социальных сетей. NLP может анализировать отзывы пользователей и комментарии в социальных сетях, чтобы лучше осмысливать огромные объемы информации. Анализ тональности текста выявляет положительные и отрицательные комментарии в социальных сетях, позволяя оценивать реакцию клиентов в реальном времени. Это может принести значительную выгоду в дальнейшем, например повышение удовлетворенности покупателей и рост доходов.
Анализ рынка. Если использовать NLP для анализа языка клиентов компании, можно лучше понять, что они хотят и как с ними взаимодействовать. Аспектно-ориентированный анализ тональности текста определяет тональность высказываний, связанных с определенными аспектами или продуктами, в социальных сетях (например: «клавиатура отличная, а экран слишком тусклый») и предоставляет информацию, на основе которой можно сразу вносить изменения в дизайн продуктов или рекламные кампании.
Модерация контента. Если ваша компания привлекает множество пользователей или клиенты оставляют много комментариев, NLP позволит модерировать высказывания, чтобы обеспечить их качество и вежливость. Этого можно добиться, анализируя не только слова, но и тональность и суть комментариев.
Отрасли, использующие обработку текстов на естественном языке
NLP упрощает и автоматизирует многие бизнес-процессы, особенно такие, в которых нужно обрабатывать множество неструктурированных текстов, например электронные письма, опросы, переписки в социальных сетях и т. д. Используя NLP, компании могут лучше анализировать имеющиеся данные, чтобы принимать правильные решения. Приведем несколько примеров применения NLP на практике:
- Здравоохранение. Системы здравоохранения по всему миру переходят к использованию электронных медицинских записей и сталкиваются с необходимостью обрабатывать огромные объемы неструктурированных данных. Для анализа медицинских записей и получения статистических данных можно использовать NLP.
- Юриспруденция. Чтобы подготовиться к суду, юристам порой приходится часами разбирать документы в поисках материалов, относящихся к делу. Технология NLP может автоматизировать процедуру раскрытия информации по запросу, отфильтровывая многочисленные документы, что позволит сэкономить время и избежать ошибок, обусловленных человеческим фактором.
- Финансы. Финансовая сфера развивается очень быстро, поэтому крайне важно иметь конкурентное преимущество. Трейдеры используют технологию NLP для автоматического поиска информации в корпоративных документах и новых публикациях, чтобы получить именно те данные, которые актуальны для их портфолио или для принятия решений о покупке или продаже.
- Обслуживание клиентов. Многие крупные компании используют виртуальных помощников или чат-боты, чтобы они отвечали на простые вопросы клиентов (такие, как часто задаваемые вопросы) или перенаправляли клиентов к специалистам в случае сложных вопросов.
- Страхование. Крупные страховые компании используют NLP, чтобы отфильтровывать документы и отчеты по страховым искам и таким образом оптимизировать работу.
Обзор технологий NLP
Модели машинного обучения для NLP. Как мы уже говорили, современные технологии NLP в значительной степени основаны на одном из направлений ИИ, которое называется машинное обучение. Машинное обучение строит прогнозы на основе обобщения примеров из набора данных. Этот набор данных называется обучающей выборкой, и алгоритмы машинного обучения учатся на этих данных, чтобы создать модель машинного обучения, которая выполнит поставленную задачу.
Например, обучающая выборка для анализа тональности текста состоит из предложений с указанием их эмоциональной окраски (положительной, отрицательной или нейтральной). Алгоритм машинного обучения обрабатывает эти данные и строит модель, которая способна получать на входе предложения, а на выходе определять их тональность. Такая модель, которая получает на входе предложения или документы, а на выходе возвращает определенные метки к полученным данным, называется моделью классификации документов. Классификаторы документов могут также классифицировать документы по упомянутым в них темам (таким как спорт, финансы, политика и т. д.)
Другой вид модели используется для распознавания и классификации объектов в документах. Для каждого слова в документе модель предсказывает, относится ли оно к одному из указанных типов объектов, и если да, то к какому. Например, в предложении «Акции корпорации XYZ продавались вчера по 28 долларов» слова «корпорация XYZ» — это компания, «28 долларов» — сумма в валюте, а «вчера» — дата. Обучающей выборкой для распознавания объектов является коллекция текстов, в которых каждое слово имеет метку, указывающую тип объекта. Такая модель, которая на выходе возвращает метку для каждого слова, называется моделью маркировки последовательности.
Модели «последовательность-в-последовательность» сравнительно недавно пополнили семейство моделей, которые используются в NLP. Модель «последовательность-в-последовательность» (sequence to sequence или seq2seq) принимает на входе целое предложение или документ (так же, как классификатор документов), но на выходе возвращает предложение или другую последовательность (например. компьютерную программу). (Классификатор документов возвращает на выходе один символ.) Среди примеров использования моделей seq2seq можно назвать машинный перевод, который получает на входе, например, предложение на английском, а возвращает на выходе предложение на французском языке; аннотирование документов (когда на выходе возвращается краткая аннотация поступившего на вход текста) и семантический анализ (когда на входе поступает запрос на английском языке, а на выходе возвращается компьютерная программа, реализующая этот запрос).
Глубокое обучение, предварительно обученные модели и обучение с переносом. Глубокое обучение — это самый распространенный вид машинного обучения в NLP. В 1980-х годах исследователи создали нейронные сети, в которых множество примитивных моделей машинного обучения объединяются в одну общую сеть. По аналогии с человеческим мозгом такие простые модели машинного обучения иногда называют нейронами. Эти нейроны распределяются по уровням, и глубокая нейронная сеть — это сеть с большим количеством уровней. Глубокое обучение — это машинное обучение, которое использует модели глубокой нейронной сети.
Из-за высокой сложности глубоких нейронных сетей для их обучения обычно требуются большие объемы данных, значительные вычислительные мощности и много времени. Современные модели глубоких нейронных сетей в NLP обучаются на массиве разнообразных источников, таких как Википедия и данные, отобранные из Интернета. Объем обучающей выборки может составлять 10 ГБ или больше, и высокопроизводительному вычислительному кластеру может потребоваться не менее недели, чтобы обучить глубокую нейронную сеть. (Исследователи считают, что обучение еще более глубоких моделей на еще больших объемах данных обеспечивает более высокую производительность, поэтому сейчас все стараются обучать огромные модели на все больших наборах данных.)
Может показаться, что растущие требования к данным и вычислительным мощностям ограничивают ту пользу, которую могут принести глубокие нейронные сети. Однако обучение с переносом позволяет дополнительно обучать уже обученную нейронную сеть, чтобы она могла решать новые задачи, и в этом случае можно обойтись гораздо меньшей обучающей выборкой и вычислительными мощностями. Самый простой вид обучения с переносом называется дообучение. Сначала модель обучается на довольно большом общем наборе данных (например, из Википедии), а затем проводится дополнительное обучение («дообучение») модели на гораздо меньшем наборе специально подобранных данных, маркированных с указанием реальной целевой задачи. Как ни удивительно, наборы данных для дообучения могут быть очень маленькими и включать в себя всего сотни, а иногда даже десятки обучающих примеров, а само дообучение может выполняться за несколько минут всего на одном процессоре. Обучение с переносом упрощает развертывание моделей глубокого обучения по всему предприятию.
Сейчас уже сформировалась целая экосистема поставщиков предобученных моделей глубокого обучения, которые уже обучены на материале различных языков и их сочетаний, наборов данных и задач предварительного обучения. Такие предобученные модели можно скачивать и дообучать самым разным целевым задачам.
Пример методов предварительной обработки в NLP
Токенизация. Токенизация сегментирует необработанный текст (например, предложение или документ) на последовательность токенов, таких, как слова или еще более мелкие элементы. Токенизация часто служит первым этапом в процессе обработки текстов на естественном языке. Токены — это обычно повторяющиеся последовательности в тексте, которые используются как минимальные единицы для дальнейшей обработки. Токенами могут быть слова, части слов, которые называются морфемами (например, приставки, такие как «пред-», или суффиксы, такие как «-ик»), или даже отдельные символы.
Мешки слов. В моделях «мешок слов» документы рассматриваются как неупорядоченные коллекции токенов или слов (мешок похож на множество за одним исключением: он фиксирует, сколько раз встречается каждый элемент). Поскольку эти модели не учитывают порядок слов, то для них нет разницы между предложениями «мать любит дочь» или «дочь любит мать». Однако мешки слов часто используются для повышения эффективности при выполнении задач информационного поиска на большом объеме данных, например в поисковых системах. Они позволяют добиться великолепных результатов при работе с длинными документами.
Удаление стоп-слов. Стоп-слово — это токен, который не учитывается при дальнейшей обработке. Обычно это короткие, часто встречающиеся слова, такие как «и», «а» или «в». Мешки слов и поисковые системы часто игнорируют стоп-слова, чтобы сократить время обработки и объем хранилища в базе данных. Глубокие нейронные сети обычно учитывают порядок слов (то есть они не являются мешками слов) и не удаляют стоп-слова, потому что они могут передавать тонкие оттенки значений (например, выражения «смотреть в окно» и «смотреть на окно» различаются по значению, но после удаления стоп-слов они будут выглядеть одинаково).
Стемминг и лемматизация. Морфемы — это самые маленькие языковые единицы, имеющие значение. Обычно морфемы меньше слов. Например, слово «перечитал» состоит из приставки «пере», корня «чит», суффикса «а» и суффикса прошедшего времени «л». Стемминг и лемматизация приводят слово к его словарной форме (например, «перечитать + прошедшее время). Стемминг и лемматизация представляют собой важный этап на пути к моделям глубокого обучения. Но модели глубокого обучения обычно сами способны выявлять подобные закономерности из обучающей выборки, поэтому в использовании отдельных алгоритмов стемминга и лемматизации нет необходимости.
Частеречная разметка и синтаксический анализ. Частеречная разметка (PoS-тегирование) маркирует каждое слово, указывая его часть речи (например, существительное, глагол, прилагательное и т. д.). Синтаксический анализ определяет, как слова объединяются в словосочетания, простые и сложные предложения. Частеречная разметка — это задача по маркировке последовательности, синтаксический анализ — это усложненная разновидность задачи по маркировке последовательности, а глубокие нейросети — это новейшая технология, способная решать как задачи частеречной разметки, так и задачи синтаксического анализа. До появления глубокого обучения частеречная разметка и синтаксический анализ были важными этапами для понимания предложения. Однако для современных моделей глубокого обучения в NLP частеречная разметка и синтаксическая информация не дают особых преимуществ, поэтому эти задачи редко используют в рамках глубокого обучения для NLP.
Языки программирования для NLP
Python
В языке программирования Python предусмотрены библиотеки и наборы инструментов для NLP, поэтому на данный момент большинство проектов по NLP разрабатываются именно на языке Python. Интерактивная среда разработки Python упрощает разработку и тестирование новых программ.
Java и C++
Для обработки больших объемов данных часто предпочитают языки программирования C++ и Java, потому что они позволяют создавать более эффективный программный код.
Библиотеки и среды разработки NLP
Вот несколько примеров популярных библиотек NLP:
TensorFlow и PyTorch. Это два самых популярных инструментария для глубокого обучения. Они легко доступны для исследовательских и коммерческих целей. Хотя они поддерживают несколько языков, основным для них является язык Python. В обоих инструментариях есть большие библиотеки и встроенные компоненты, так что даже для самых сложных моделей глубокого обучения в NLP зачастую достаточно подключения к этим компонентам. Они также поддерживают инфраструктуру высокопроизводительных вычислений, такую как кластеры машин с ускорителями графических процессоров. Для них созданы прекрасные учебные материалы и другие документы.
AllenNLP. Это библиотека компонентов верхнего уровня для NLP (например, простых чат-ботов), применяемых в PyTorch и Python. Для нее также есть превосходная документация.
HuggingFace. Эта компания распространяет сотни различных предварительно обученных моделей глубокого обучения для NLP, а также готовые к работе комплекты инструментов ПО в TensorFlow PyTorch, что позволяет разработчикам быстро оценивать, насколько хорошо различные предварительно обученные модели справляются с интересующими их задачами.
Spark NLP. Spark NLP — это библиотека обработки текстов с открытым исходным кодом для выполнения сложных задач NLP на языках программирования Python, Java и Scala. Она предназначена для того, чтобы предоставить прикладной программный интерфейс (API) для обработки текстов на естественных языках. Она предлагает предварительно обученные модели нейросетей, конвейеры и встраивания, а также поддержку обучения пользовательских моделей.
SpaCy NLP. SpaCy — это бесплатная библиотека с открытым исходным кодом для выполнения сложных задач NLP на языке Python. Она специально была создана для того, чтобы помочь в создании приложений, способных обрабатывать и понимать большие объемы текстов. Библиотека SpaCy интуитивно понятна и справляется с многими задачами, необходимыми для стандартных проектов NLP.
Итак, обработка текстов на естественных языках — это очень интересное направление развития искусственного интеллекта, которое стимулирует создание целого ряда новых продуктов, таких как поисковые системы, чат-боты, системы рекомендаций и системы преобразования речи в текст. Поскольку взаимодействие человека с компьютером все дальше уходит от использования кнопок, форм и предметно-ориентированных языков, спрос на решения, основанные на обработке текстов на естественных языках, продолжает расти. Поэтому Oracle Cloud Infrastructure повышает эффективность выполняемых локально процессов за счет использования оптимизированных по производительности вычислительных шаблонов и инструментов для NLP. Oracle Cloud Infrastructure предлагает массив шаблонов для графических процессоров, которые можно развернуть за несколько минут и начать экспериментировать с NLP.
Методы обработки естественного языка

В последнее десятилетие технологии искусственного интеллекта и машинной обработки естественной речи пережили скачок развития. В жизнь человека прочно вошли виртуальные ассистенты, способные на полноценный диалог. Всё это стало возможным благодаря методам автоматической обработки естественного языка.

Что такое обработка естественного языка
Natural Language Processing — область в науке, объединяющая два направления: гуманитарную лингвистику и инновационные технологии искусственного интеллекта. Задача NLP — создать условия для понимания компьютером смысла речи человека. Это непросто из-за особенностей предмета анализа:
- Язык наделён осмысленностью. Это не просто звуки и буквы, а способ передачи информации, которую нужно интерпретировать.
- Фразы произносятся с различными интонациями, акцентом, ударениями, бывает, что речь слишком быстрая, и некоторые слова « съедаются » . Люди понимают друг друга благодаря лингвистическому опыту и образному мышлению. Машинам же для понимания смысла необходима обработка множества параметров.
- Синтаксические, грамматические, лексические нюансы усложняют восприятие. Слова с одинаковым написанием и звучанием могут иметь разное значение: например, « стекло » может быть существительным и глаголом. Поэтому важно научить искусственный интеллект видеть смысловую связь.
- Любой язык богат жаргонизмами, неологизмами, профессиональной, фольклорной и другими видами лексики. Люди постоянно пополняют свой словарный запас. Машинные алгоритмы понимания речи тоже должны непрерывно обучаться.
Языковое общение — по-прежнему основной способ передачи и обработки информации для человека. По смыслу слов и интонации люди понимают намерения друг друга, а благодаря NLP этому научились и виртуальные ассистенты.
Так, Sber предлагает разработчикам приложений с виртуальными ассистентами Салют улучшить качество их взаимодействия с аудиторией. Для этого есть платформа для обработки запросов на естественном языке SmartNLP. Система определяет более 600 тематик, таких как медиа и видео, банковские сервисы, погода.
Навык постоянно совершенствуется благодаря тому, что каждый запрос пользователя проходит стадию предобработки текста. Исходные данные модифицируются и стандартизируются для дальнейшего использования ML-моделями:
- Применяется лемматизация и нормализация текста, чтобы привести слова к нормальной форме, исправляются ошибки, где нужно, буква « е » заменяется на « ё » .
- Определяются члены предложения и части речи для дальнейшей работы с входящими запросами.
- Выделяются именованные сущности, которые помогают собственной разработке Сбера — интентрекогнайзеру — понимать намерения пользователя. Эти сущности также могут использоваться внешними системами для работы с текстом. Сейчас выделяется более 30 сущностей, среди которых обозначения денежных знаков, локации и другие.
Намерение пользователя определяется двумя способами:
- Подход, основанный на правилах. Подойдёт для простых запросов, например о погоде или ближайшем магазине. По настроенным правилам система понимает намерение пользователя.
- С помощью текстового классификатора. Это глубокая модель машинного обучения, основанная на Roberta. В этом случае текст проходит через токенизацию, попадает в модель, и на выходе мы получаем нужный класс намерения пользователя.
В результате обработки сигналов от векторов система получает конкретные команды, по которым запускается навык в виртуальном ассистенте.
Современные инструменты работы с речью позволяют быстро обрабатывать поступающие обращения, искать нужную информацию, сохранять транскрипции видеовыступлений. Появляются новые способы применения технологии искусственного интеллекта и Natural Language Processing. Разрабатываются сервисы для внедрения машинной обработки естественного языка в собственные продукты, расширения функциональности существующих решений.
Основной технологией в направлении Natural Language Processing становится deep learning. Глубокое обучение возможно благодаря следующим предпосылкам:
- Для обучения моделей стали доступны суперкомпьютеры с большим количеством GPU.
- Разработчики накопили достаточно тренировочных данных для машинного обучения.
Алгоритмы глубокого обучения самостоятельно выделяют признаки из необработанных данных, поэтому NLP практически полностью автоматизирована и имеет высокую точность понимания речи.
Видеозвонки в SberJazz
Общайтесь с друзьями и близкими где бы вы ни были
Попробовать сейчас
Какие задачи сегодня может решать NLP?
В общем смысле задачи NLP-технологий распределяются по уровням:
- На сигнальном уровне нейросетевые системы могут распознавать и синтезировать устную и письменную речь — автоматическая запись бесед, транскрибация, речевая аналитика.
- На уровне слова возможен его морфологический разбор, приведение в соответствие с нормами — автоматическое исправление, проверка грамматики.
- При работе со словосочетаниями NLP позволяет выделять сущности, отдельные слова, тегировать части речи.
- В предложениях искусственный интеллект точно определяет точки, отличает конец предложения от сокращения слова.
- При анализе абзаца алгоритм распознает язык, эмоциональную окраску, выявит отношения между смысловыми единицами.
- В объёмных документах система определит тематику, составит аннотацию или краткое изложение, перепишет текст другими словами без потери смысла.
- При работе с текстовым кластером Natural Language Processing устранит дубликаты, отыщет нужную информацию по меткам.
NLP используют в бизнесе, науке и других сферах для решения самых разных задач. Среди них можно выделить:
- Сегментирование и определение целевых категорий клиентов. Например, автоматический анализ текстовых сообщений пользователя в игре — метод прогноза и предотвращения его ухода.
- Поиск, разделение на категории отзывов и комментариев о работе.
- Алгоритмы классификации входящих обращений по содержанию.
- Автоматизация взаимодействия с клиентами.
- Способность нейросети создавать краткие изложения любых текстов, выделяя важное.
Рассмотрим подробнее несколько методов Natural Language Processing, которые активно применяются в различных отраслях.

Машинный перевод
Методы глубокого обучения сделали автоматический перевод не механическим, а таким, будто компьютер понимает смысл фраз на языке оригинала. Система не переводит каждое слово отдельно. Машинный интеллект анализирует смысл целой фразы или предложения, « видит » знаки препинания, части речи и их связь. Затем он переводит фразу на целевой язык.
Полученная при анализе и переводе информация сопоставляется, интерпретируется, после чего формируется результат — последовательность слов с тем же смыслом, но на другом языке. При этом алгоритм должен учитывать правила построения языков, согласование слов между собой, их место в предложении, правильно использовать роды, склонения, числа и так далее. Так работает модель перевода по правилам.
Другой способ — перевод по фразам — работает иначе. Система без дополнительных этапов анализа формирует несколько вариантов перевода и выбирает оптимальный на основе выученных вероятностей использования.
Подобные методы используют онлайн-переводчики, встроенные сервисы в различных приложениях. Компании могут применять технологию для взаимодействия с иностранными клиентами и контрагентами.
Голосовые помощники
В виртуальных ассистентах сочетаются два базовых решения:
- искусственный интеллект;
- машинное обучение.
Пользователь взаимодействует не с живым человеком, а с цифровым алгоритмом. Такой алгоритм должен не только анализировать полученные данные, но и предугадывать ход беседы, как реальный собеседник. Кроме того, система должна с высокой точностью выделять главное среди шума.
Для автоматической обработки прямой или записанной речи нужны специальные инструменты. Например, среди продуктов SberDevices есть платформа SaluteSpeech, с которой можно « научить » приложения понимать естественную речь человека и синтезировать голосовые ответы на запросы. Сервис позволяет создать собственного виртуального помощника, который внесёт вклад в продвижение и узнаваемость бренда.
Платформа SmartNLP от SberDevices предназначена для более точной работы ассистентов Салют. Технология помогает выбрать нужный навык ассистента для запуска, настроить алгоритм действий в случае возможных ошибок и задержек системы. К примеру, в момент ожидания ассистент может пообщаться с клиентом, развлечь интересной историей или объяснить, что произошло.
В этом важное отличие ассистентов от чат-ботов — ещё одного метода цифровизации бизнеса и автоматизации взаимодействия с клиентом. Их внедряют на сайты, в приложения, в мессенджеры. Бот может отвечать на типовые вопросы, принимать заявки, делать рассылки, информировать об изменениях и акциях.
В форме простого диалога с фразами-подсказками клиент оформит заказ, узнает его статус, запишется на приём. Бота можно наделить различными полномочиями — от деловых до развлекательных. С алгоритмом можно поиграть в города или устроить викторину. Взаимодействие возможно только текстом и строго по заданному сценарию.
SaluteBot от SberDevices интегрируется с омниканальной платформой Jivo, которая позволяет в едином пространстве обрабатывать обращения, поступающие со всех подключённых каналов. Чат-бот можно создать самостоятельно с помощью готовых шаблонов в zero-code- и low-code-конструкторах платформы Studio. Боты могут обрабатывать неограниченное количество запросов, поэтому способны решить проблему упущенных клиентов.
Анализ текстов
Есть много инструментов для анализа текста, основанных на технологиях машинного обучения и искусственного интеллекта. Они помогают оценивать тексты разных объёмов по специальным критериям. Одни предназначены для профессионального использования, другие помогают в обучении, в оценке работы сотрудников, в создании контента.
Популярные онлайн-сервисы могут:
- генерировать новые тексты по запросу;
- проверять уникальность и бороться с плагиатом;
- проводить семантический анализ текста для SEO;
- подбирать синонимы и рифмы;
- анализировать стилистическую чистоту текста;
- проверять грамматические ошибки;
- предварительно оценивать время прочтения;
- делать краткое изложение и выделять тезисы;
- переписывать тексты другими словами с сохранением общего смысла.
В линейке продуктов SberDevices есть сервисы работы с текстом Рерайтер и Суммаризатор.
Рерайтер автоматически создаёт уникальные рерайты исходников любого размера. Содержание не имеет значения, система может работать с научными статьями, художественными текстами, новостными заметками, постами для социальных сетей.
В сервис вводится текст, настраиваются параметры генерации, система создаёт несколько вариантов и выбирает из них лучший с точки зрения уникальности и соответствия первоначальному смыслу. Используемая нейросеть обучалась на объёмном пласте данных разной стилистики и жанров. В качестве базы для машинного обучения использовалась генеративная модель ruT5.
Суммаризатор позволяет выделить главные мысли и оформить их в виде кратких тезисов. Сервис актуален для людей, интересующихся наукой. Он позволяет быстро изучать объёмные научные работы.
Суммаризатор подойдёт также для работы с учебными материалами. Сокращение помогает создавать дайджесты новостей, изучать темы из письменных транскрипций лекций и семинаров.

Распознавание и синтез речи
Метод считается одним из самых популярных в NLP. Технология распознавания речи и голосового синтеза позволяет:
- озвучивать контент и интерфейсы;
- создавать субтитры;
- транскрибировать лекции и совещания;
- внедрять в продукты голосовое управление;
- создавать персонализированных виртуальных помощников;
- обрабатывать и анализировать голосовые записи;
- трансформировать телефонию, создавать IVR-меню, голосовые рассылки и обзвоны.
Платформа SaluteSpeech от Sber работает в двух направлениях:
- При распознавании речи искусственный интеллект может определять эмоции говорящего и знаки препинания. Сервис поймёт, где закончилась фраза, отфильтрует шумы. Правильно понимать прямую и записанную речь помогают специальные подсказки — хинты, которые ускоряют автоматическую реакцию системы.
- Синтез речи построен на уникальных моделях машинного обучения, которые могут решать даже узкие задачи, например правильно расставлять ударения и произносить букву « ё » . Знаний нейросети достаточно для того, чтобы без ошибок произносить термины, географические названия, большие числа и другие сложные речевые конструкции. Сервис позволяет подобрать тембр, настроение, манеру общения, мужское или женское звучание синтезируемой речи.
Попробуйте преобразование аудио в текст
Запишите голос и SaluteSpeech преобразует его в текст

Возможности платформы позволяют внедрить методы понимания естественной речи в свои продукты. Воспользоваться сервисом можно при работе над различными проектами в среде для разработчиков Studio от Sber. Тарификация посекундная и посимвольная, пользователи платят только за фактический результат.
NLP — перспективное направление развития искусственного интеллекта. Методы автоматической обработки естественного языка используют в рекламе, в информационных компаниях, в сфере безопасности. Крупные компании внедряют голосовое управление во внутреннее программное обеспечение.
Технология Natural Language Processing позволяет автоматизировать процессы, извлекать и анализировать большие объёмы информации. Растущий спрос даёт основание думать, что в ближайшие несколько лет NLP станет привычным инструментом в работе любой компании.
Продукты из этой статьи:
Natural language processing что это
NLP (Natural Language Processing, обработка естественного языка) — это направление в машинном обучении, посвященное распознаванию, генерации и обработке устной и письменной человеческой речи. Находится на стыке дисциплин искусственного интеллекта и лингвистики.
Освойте профессию «Data Scientist»
Инженеры-программисты разрабатывают механизмы, позволяющие взаимодействовать компьютерам и людям посредством естественного языка. Благодаря NLP компьютеры могут читать, интерпретировать, понимать человеческий язык, а также выдавать ответные результаты. Как правило, обработка основана на уровне интеллекта машины, расшифровывающего сообщения человека в значимую для нее информацию.
Процесс машинного понимания с применением алгоритмов обработки естественного языка может выглядеть так:
- Речь человека записывается аудио-устройством.
- Машина преобразует слова из аудио в письменный текст.
- Система NLP разбирает текст на составляющие, понимает контекст беседы и цели человека.
- С учетом результатов работы NLP машина определяет команду, которая должна быть выполнена.
Профессия / 24 месяца
Data Scientist
Дата-сайентисты решают поистине амбициозные задачи. Научитесь создавать искусственный интеллект, обучать нейронные сети, менять мир и при этом хорошо зарабатывать. Программа рассчитана на новичков и плавно введет вас в Data Science.
Кто использует NLP
Приложения NLP окружают нас повсюду. Это поиск в Google или Яндексе, машинный перевод, чат-боты, виртуальные ассистенты вроде Siri, Алисы, Салюта от Сбера и пр. NLP применяется в digital-рекламе, сфере безопасности и многих других.
Технологии NLP используют как в науке, так и для решения коммерческих бизнес-задач: например, для исследования искусственного интеллекта и способов его развития, а также создания «умных» систем, работающих с естественными человеческими языками, от поисковиков до музыкальных приложений.
Как устроена обработка языков
Раньше алгоритмам прописывали набор реакций на определенные слова и фразы, а для поиска использовалось сравнение. Это не распознавание и понимание текста, а реагирование на введенный набор символов. Такой алгоритм не смог бы увидеть разницы между столовой ложкой и школьной столовой.
NLP — другой подход. Алгоритмы обучают не только словам и их значениям, но и структуре фраз, внутренней логике языка, пониманию контекста. Чтобы понять, к чему относится слово «он» в предложении «человек носил костюм, и он был синий», машина должна иметь представление о свойствах понятий «человек» и «костюм». Чтобы научить этому компьютер, специалисты используют алгоритмы машинного обучения и методы анализа языка из фундаментальной лингвистики.
Курс для новичков «IT-специалист
с нуля» – разберемся, какая профессия вам подходит, и поможем вам ее освоить
Задачи NLP
Распознавание речи. Этим занимаются голосовые помощники приложений и операционных систем, «умные» колонки и другие подобные устройства. Также распознавание речи используется в чат-ботах, сервисах автоматического заказа, при автоматической генерации субтитров для видеороликов, голосовом вводе, управлении «умным» домом. Компьютер распознает, что сказал ему человек, и выполняет в соответствии с этим нужные действия.
Обработка текста. Человек может также общаться с компьютером посредством письменного текста. Например, через тех же чат-ботов и помощников. Некоторые программы работают одновременно и как голосовые, и как текстовые ассистенты. Пример — помощники в банковских приложениях. В этом случае программа обрабатывает полученный текст, распознает его или классифицирует. Затем она выполняет действия на основе данных, которые получила.
Извлечение информации. Из текста или речи можно извлечь конкретную информацию. Пример задачи — ответы на вопросы в поисковых системах. Алгоритм должен обработать массив входных данных и выделить из него ключевые элементы (слова), в соответствии с которыми будет найден актуальный ответ на поставленный вопрос. Для этого требуются алгоритмы, способные различать контекст и понятия в тексте.
Анализ информации. Это схожая с предыдущей задача, но цель — не получить конкретный ответ, а проанализировать имеющиеся данные по определенным критериям. Машины обрабатывают текст и определяют его эмоциональную окраску, тему, стиль, жанр и др. То же самое можно сказать про запись голоса.
Анализ информации часто используется в разных видах аналитики и в маркетинге. Например, можно отследить среднюю тональность отзывов и высказываний по заданному вопросу. Соцсети используют такие алгоритмы для поиска и блокировки вредоносного контента. В перспективе компьютер сможет отличать фейковые новости от реальных, устанавливать авторство текста. Также NLP применяется при сборе информации о пользователе для показа персонализированной рекламы или использования сведений для анализа рынка.
Станьте аналитиком данных и получите востребованную специальность
Генерация текста и речи. Противоположная распознаванию задача — генерация, или синтез. Алгоритм должен отреагировать на текст или речь пользователя. Это может быть ответ на вопрос, полезная информация или забавная фраза, но реплика должна быть по заданной теме. В системах распознавания речи предложения разбиваются на части. Далее, чтобы произнести определенную фразу, компьютер сохраняет их, преобразовывает и воспроизводит. Конечно, на границах «сшивки» могут возникать искажения, из-за чего голос часто звучит неестественно.
Генерация текста не ограничивается шаблонными ответами, заложенными в алгоритм. Для нее используют алгоритмы машинного обучения. «Говорящие» программы могут учиться на основе реальных данных. Можно добиться того, чтобы алгоритм писал стихи или рассказы с логичной структурой, но они обычно не очень осмысленные.
Автоматический пересказ. Это направление также подразумевает анализ информации, но здесь используется и распознавание, и синтез.Задача — обработать большой объем информации и сделать его краткий пересказ. Это бывает нужно в бизнесе или в науке, когда необходимо получить ключевые пункты большого набора данных.
Машинный перевод. Программы-переводчики тоже используют алгоритмы машинного обучения и NLP. С их использованием качество машинного перевода резко выросло, хотя до сих пор зависит от сложности языка и связано с его структурными особенностями. Разработчики стремятся к тому, чтобы машинный перевод стал более точным и мог дать адекватное представление о смысле оригинала во всех случаях.
Машинный перевод частично автоматизирует задачу профессиональных переводчиков: его используют для перевода шаблонных участков текста, например в технической документации.
Как обрабатывается текст
Алгоритмы не работают с «сырыми» данными. Большая часть процесса — подготовка текста или речи, преобразование их в вид, доступный для восприятия компьютером.
Очистка. Из текста удаляются бесполезные для машины данные. Это большинство знаков пунктуации, особые символы, скобки, теги и пр. Некоторые символы могут быть значимыми в конкретных случаях. Например, в тексте про экономику знаки валют несут смысл.
Препроцессинг. Дальше наступает большой этап предварительной обработки — препроцессинга. Это приведение информации к виду, в котором она более понятна алгоритму. Популярные методы препроцессинга:
- приведение символов к одному регистру, чтобы все слова были написаны с маленькой буквы;
- токенизация — разбиение текста на токены. Так называют отдельные компоненты — слова, предложения или фразы;
- тегирование частей речи — определение частей речи в каждом предложении для применения грамматических правил;
- лемматизация и стемминг — приведение слов к единой форме. Стемминг более грубый, он обрезает суффиксы и оставляет корни. Лемматизация — приведение слов к изначальным словоформам, часто с учетом контекста;
- удаление стоп-слов — артиклей, междометий и пр.;
- спелл-чекинг — автокоррекция слов, которые написаны неправильно.
Методы выбирают согласно задаче.
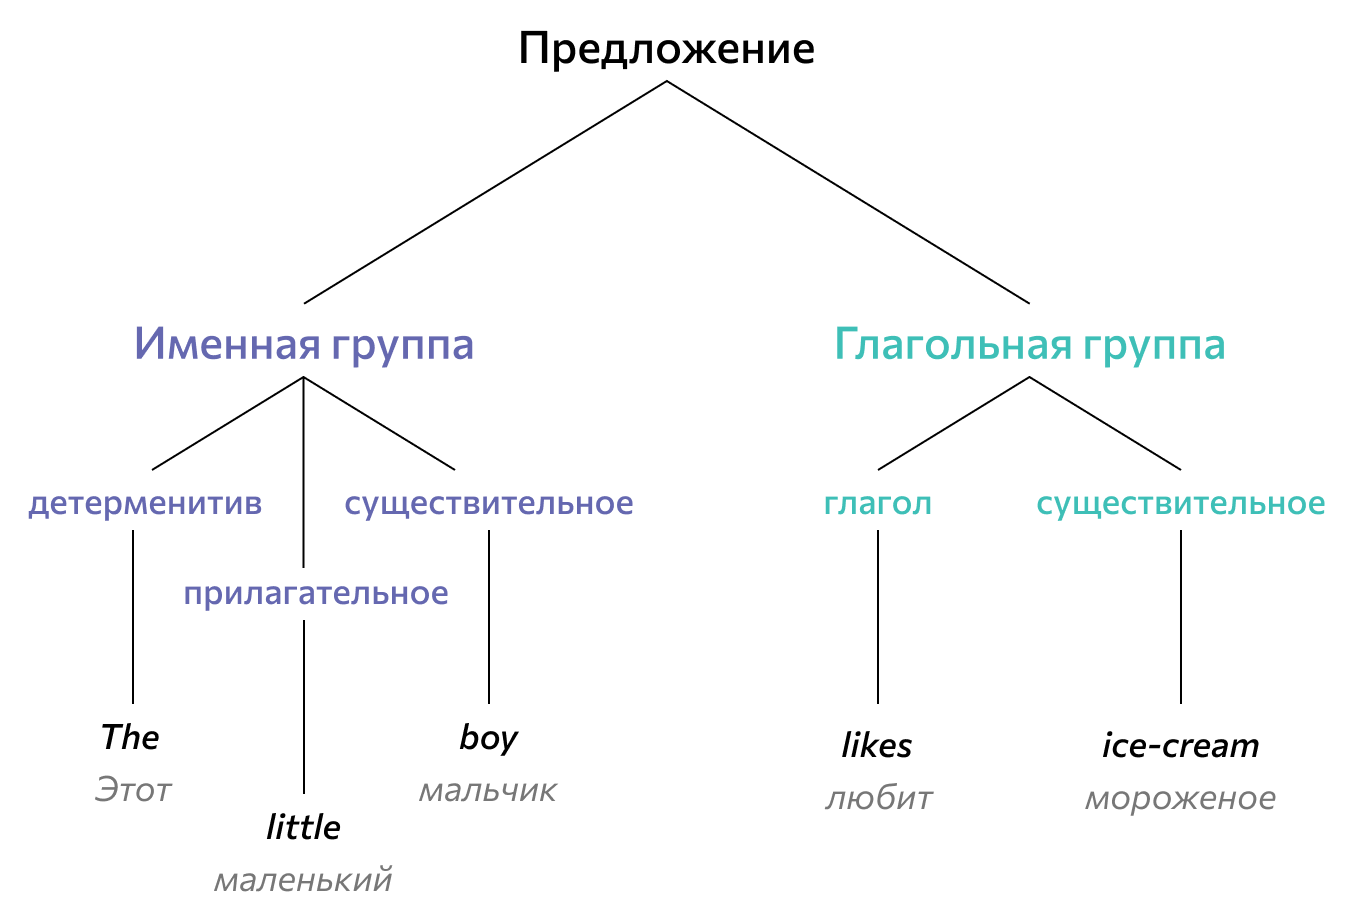
Векторизация. После предобработки на выходе получается набор подготовленных слов. Но алгоритмы работают с числовыми данными, а не с чистым текстом. Поэтому из входящей информации создают векторы — представляют ее как набор числовых значений.
Популярные варианты векторизации — «мешок слов» и «мешок N-грамм». В «мешке слов» слова кодируются в цифры. Учитывается только количество слова в тексте, а не их расположение и контекст. N-граммы — это группы из N слов. Алгоритм наполняет «мешок» не отдельными словами с их частотой, а группами по несколько слов, и это помогает определить контекст.
Применение алгоритмов машинного обучения. С помощью векторизации можно оценить, насколько часто в тексте встречаются слова. Но большинство актуальных задач сложнее, чем просто определение частоты — тут нужны продвинутые алгоритмы машинного обучения. В зависимости от типа конкретной задачи создается и настраивается своя отдельная модель.
Алгоритмы обрабатывают, анализируют и распознают входные данные, делают на их основе выводы. Это интересный и сложный процесс, в котором много математики и теории вероятностей.
Аналитик данных
Аналитики влияют на рост бизнеса. Они выясняют, какой товар и в какое время больше покупают. Считают юнит-экономику. Оценивают окупаемость рекламной кампании. Поэтому компании ищут и переманивают таких специалистов.
Статьи по теме: